AI视频跨镜头角色一致性怎么解决:角色资产卡
一、先看清问题出在哪一步
电商内容生产最近两年的变化,有一件事是被低估的:要出的不再是「一条片子」,而是「一组片子」。
同一条连衣裙,要出六种颜色、三种比例、四个区域的版本;同一位模特,要在二十条短视频里都是同一个人;同一套包装,要在大促素材、详情页长图、直播间切片里长得一模一样。单条内容的质量早就不是瓶颈了,批量生产时的身份统一才是。
问题通常以一种很具体的方式暴露出来:第一条片子很好,第二条里模特的颧骨低了一点,第三条换了发型,到第十条的时候,顾客已经不知道自己看的还是不是同一个品牌。
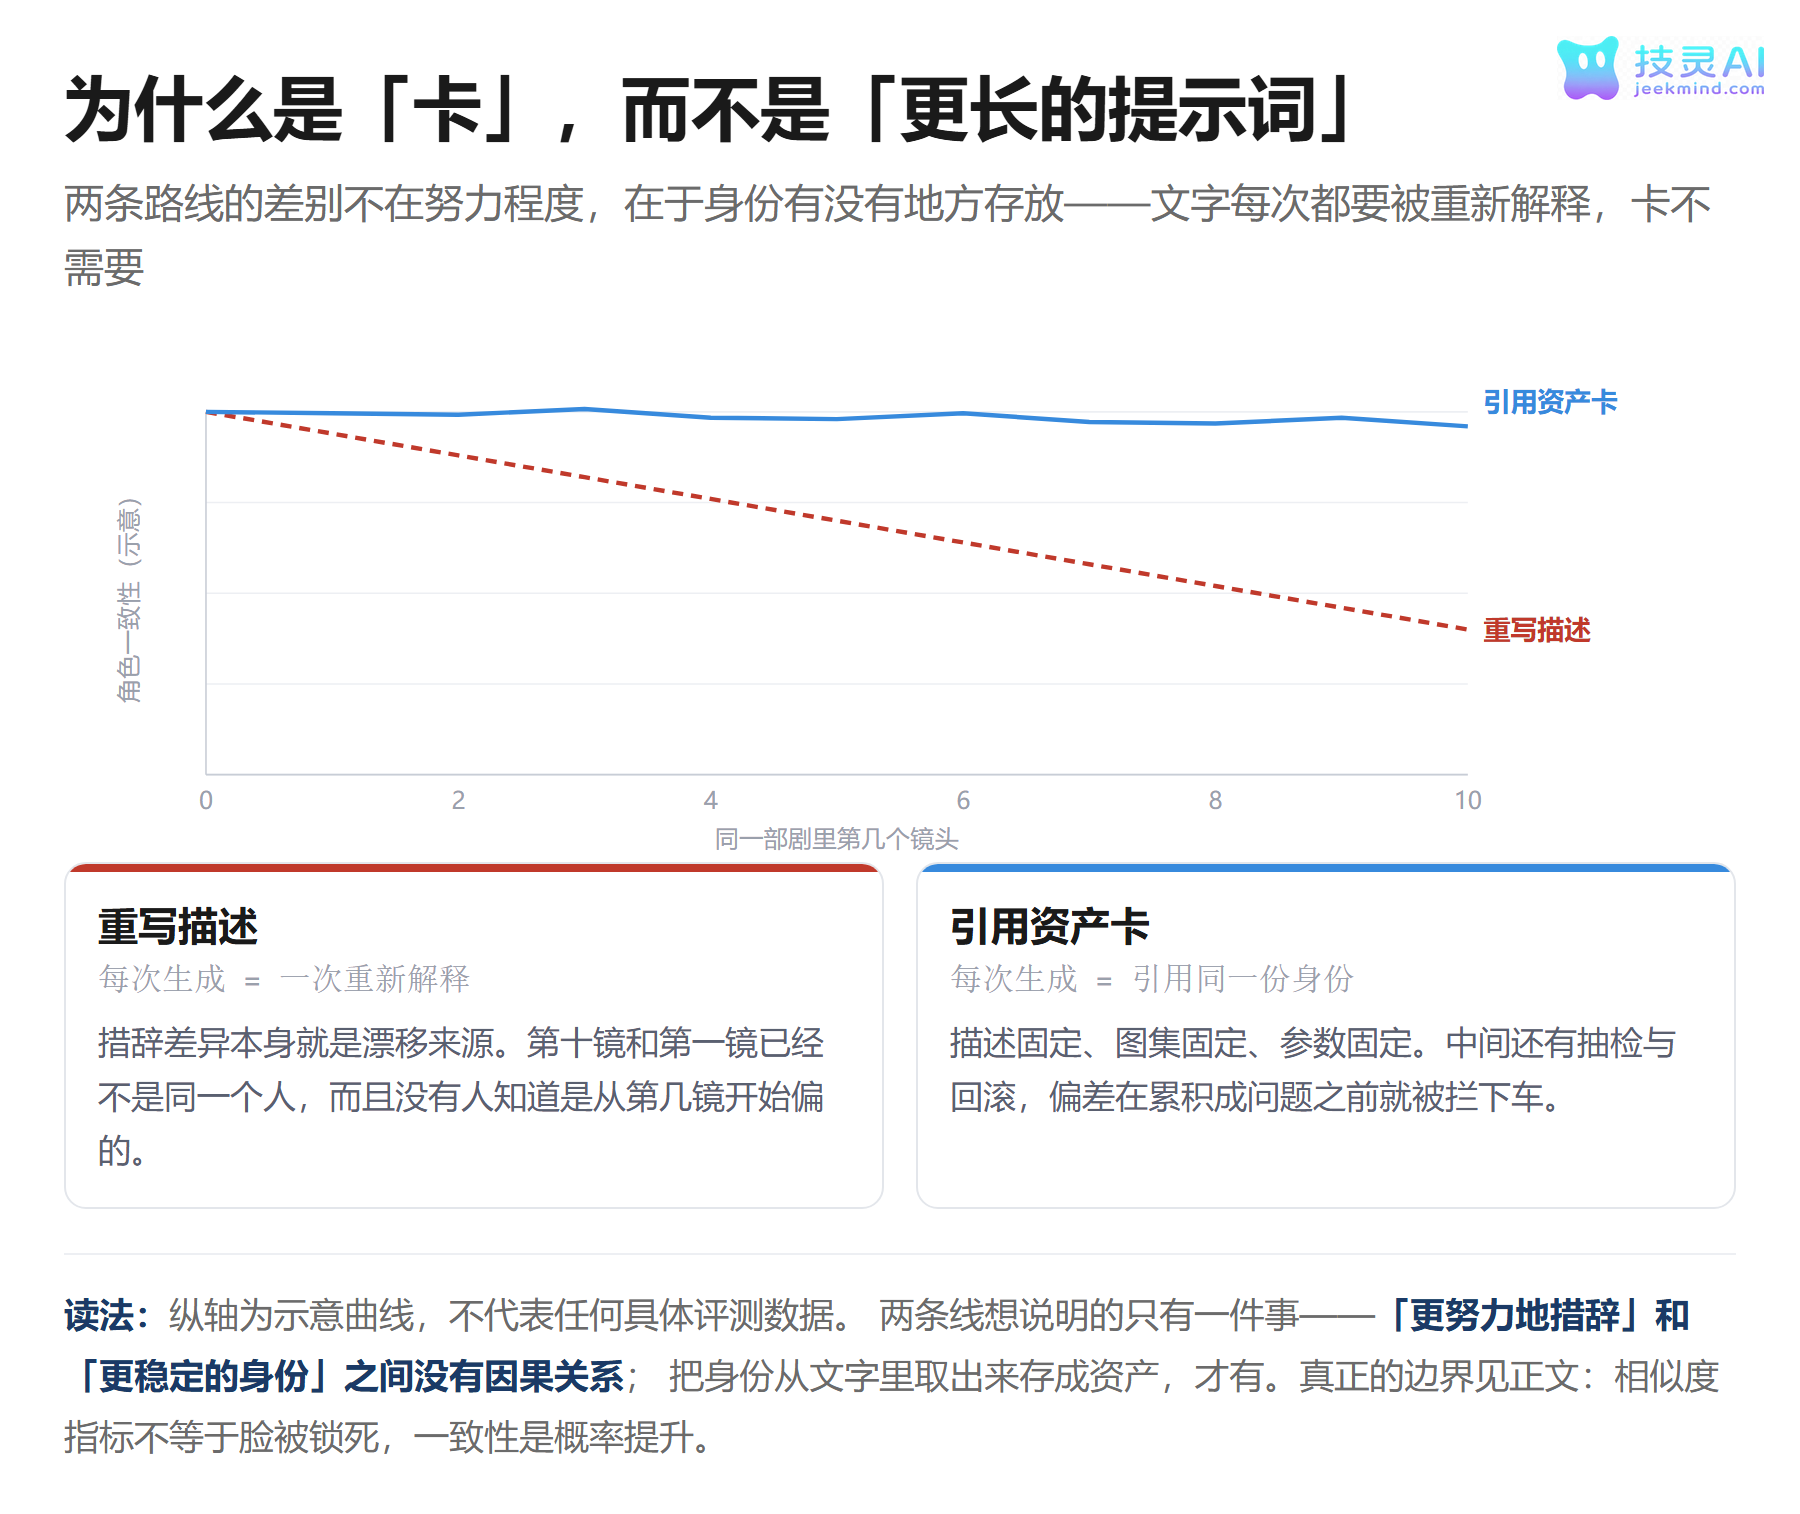
多数团队对这种偏差的第一反应是「再多拍几张参考图」「把描述写得再细一点」。这两招之所以不管用,原因只有一个:文字是有损的。 「一位二十七八岁、齐肩深棕发的模特」这句话给模型留出的解释空间极大,你写得越细,它在没被写到的维度上自由发挥得越多。
真正缺的不是更细的描述,是一张卡。
二、把「人」和「货」分别做成一张卡
在电商场景里,需要被锁住的对象有两个:模特和商品。它们得分成两张独立的卡来管理,因为它们的可变性完全不同——模特可以换妆造、换服装,但五官不能变;商品可以换场景、换光线,但外观细节一个字都不能错。
2.1 模特卡
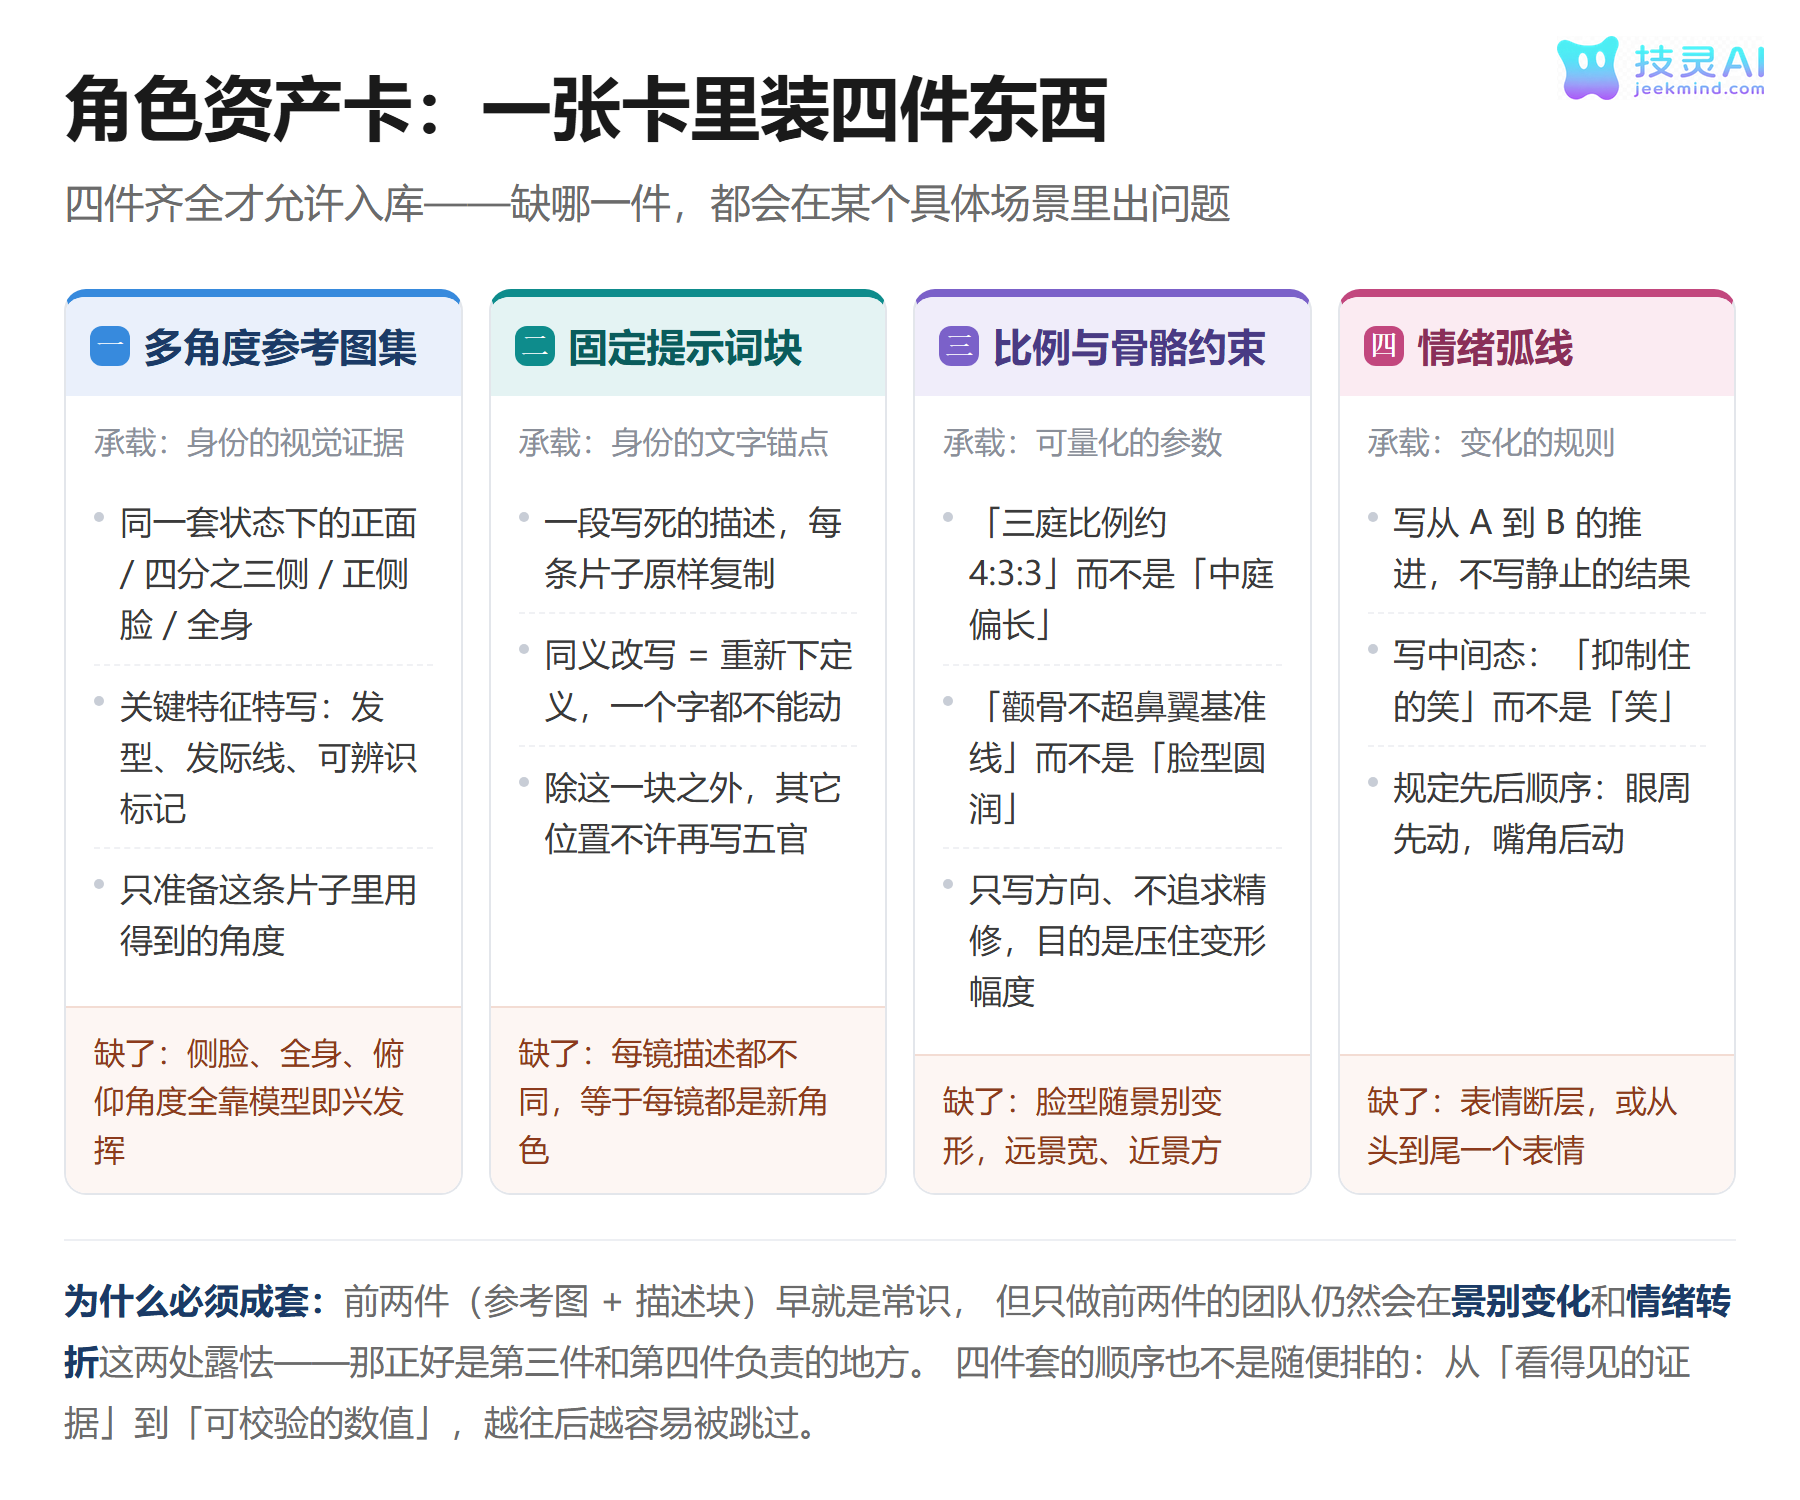
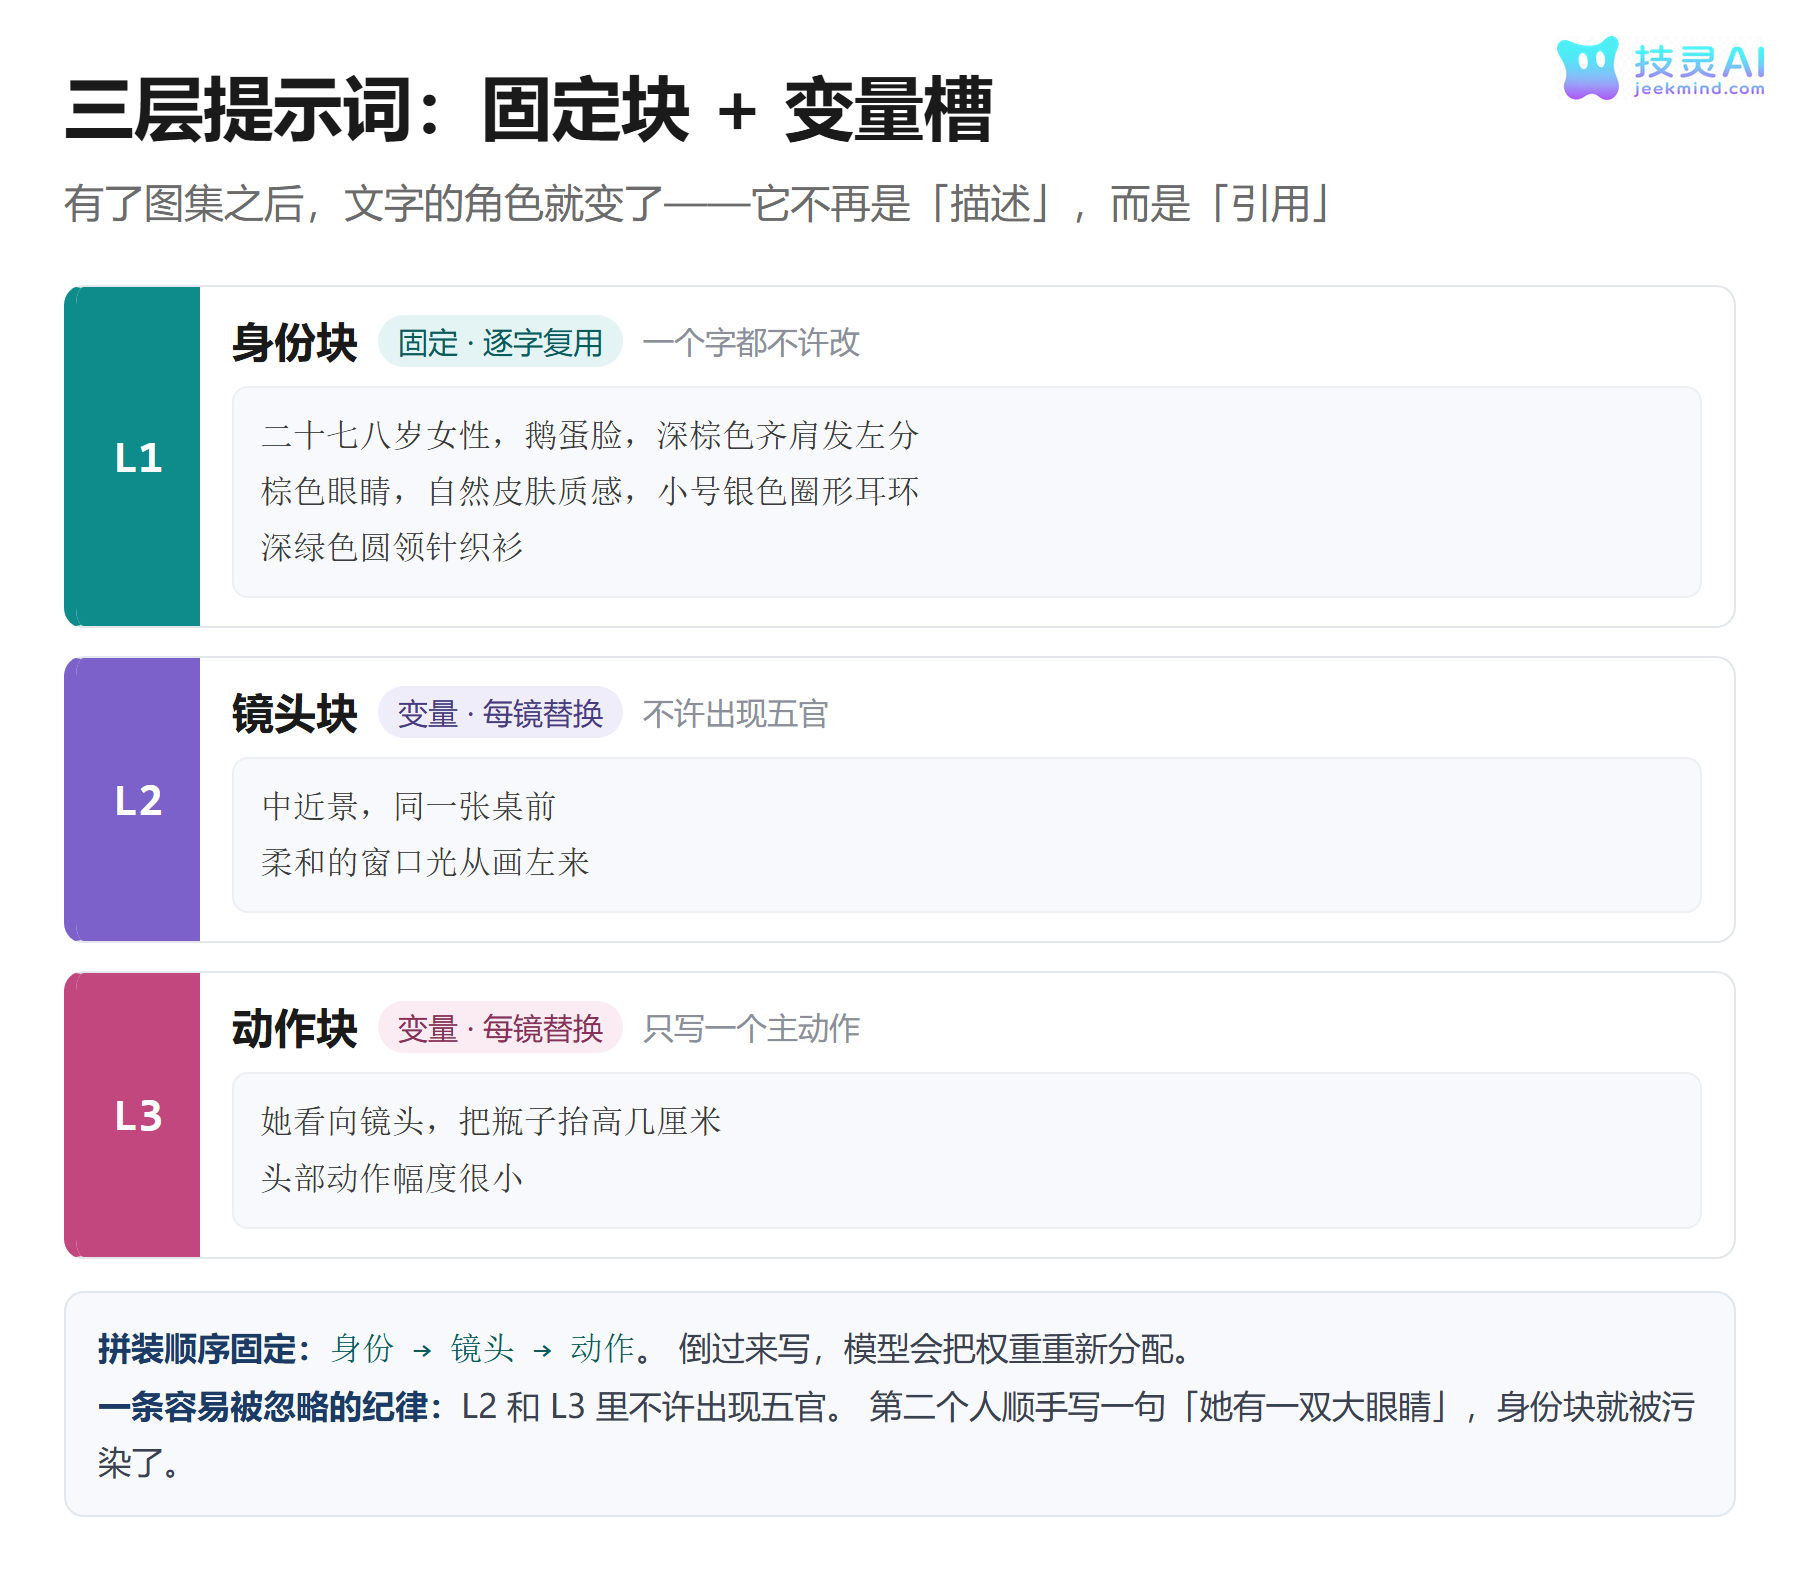
一张能跨条复用的模特卡,包含四件事:
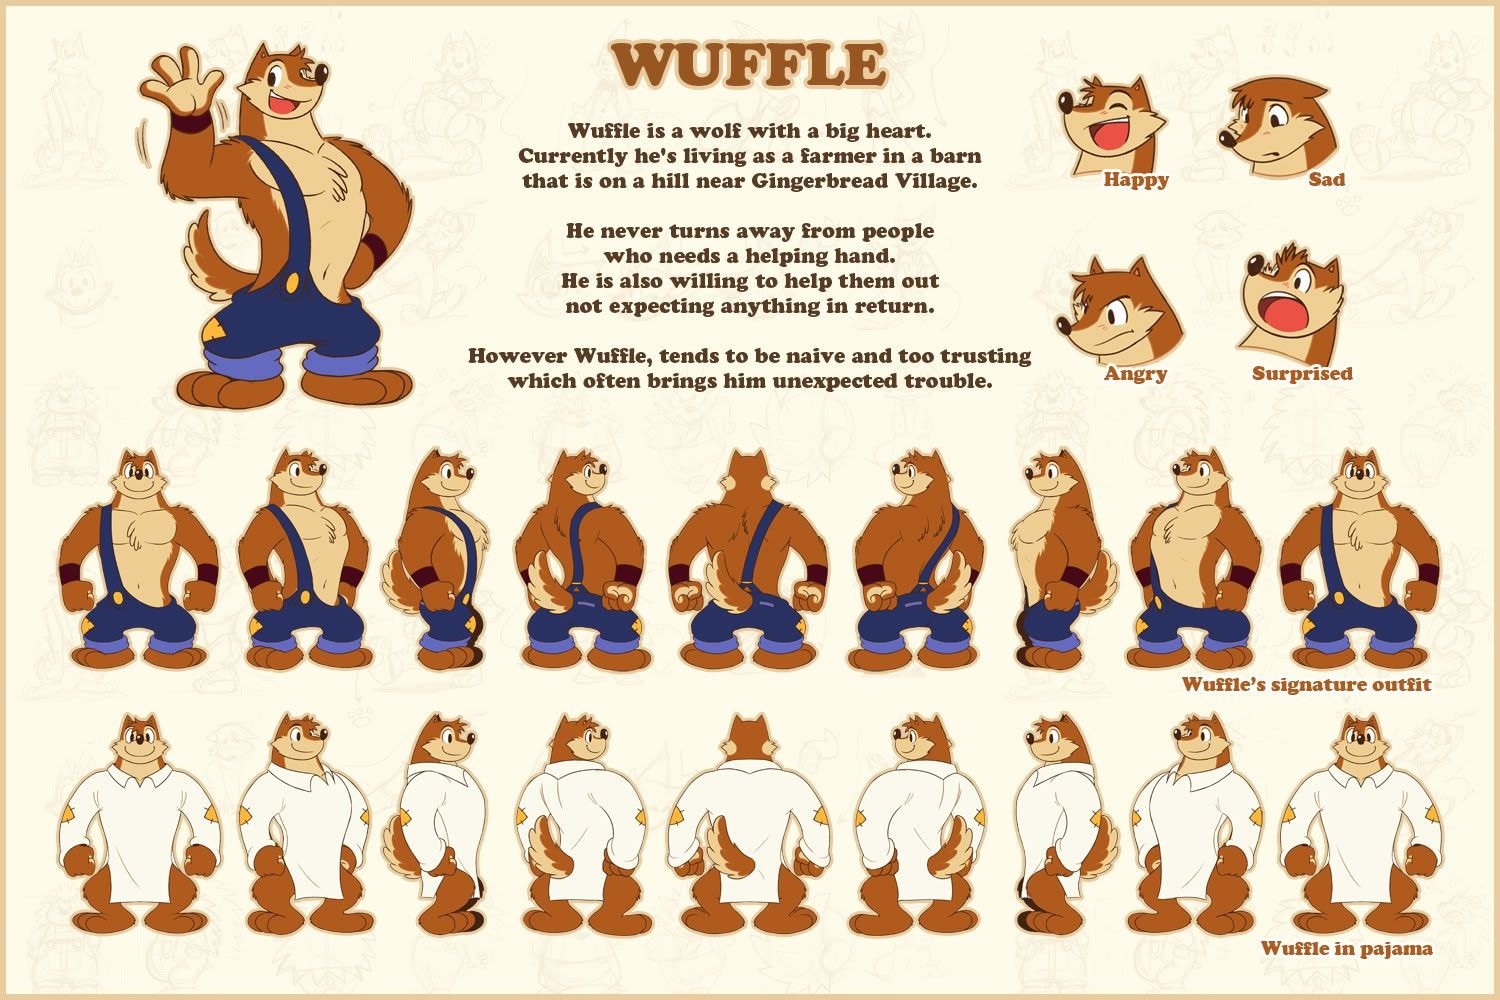
① 多角度图集。 正面、四分之三侧、正侧脸、全身,加上关键特征特写。这里有个容易漏的点:正侧脸是最容易被省、也最补信息的一张。只有正脸和四分之三侧,模型在需要侧身或转身的镜头里只能靠自己猜,猜出来的侧脸往往「像但不是」。
② 逐字复用的描述块。 把模特描述写成一段固定文字,每条片子的提示词里原样复制,一个字都不改。「深棕色齐肩发」和「棕色及肩长发」在模型眼里是两个不同的人——这不是模型笨,是同义改写等于重新下定义。

③ 可量化的约束参数。 形容词无法校验,数值可以。「脸型圆润」没法比,但「颧骨不超鼻翼基准线、下颌角圆润无折角」「三庭比例约 4:3:3」可以拿来在出片后做比对。这类参数的作用不是精修一张脸,是压住脸型随景别变形的幅度——远景把下巴拉宽、近景把脸变方,是同一类问题的两种表现。
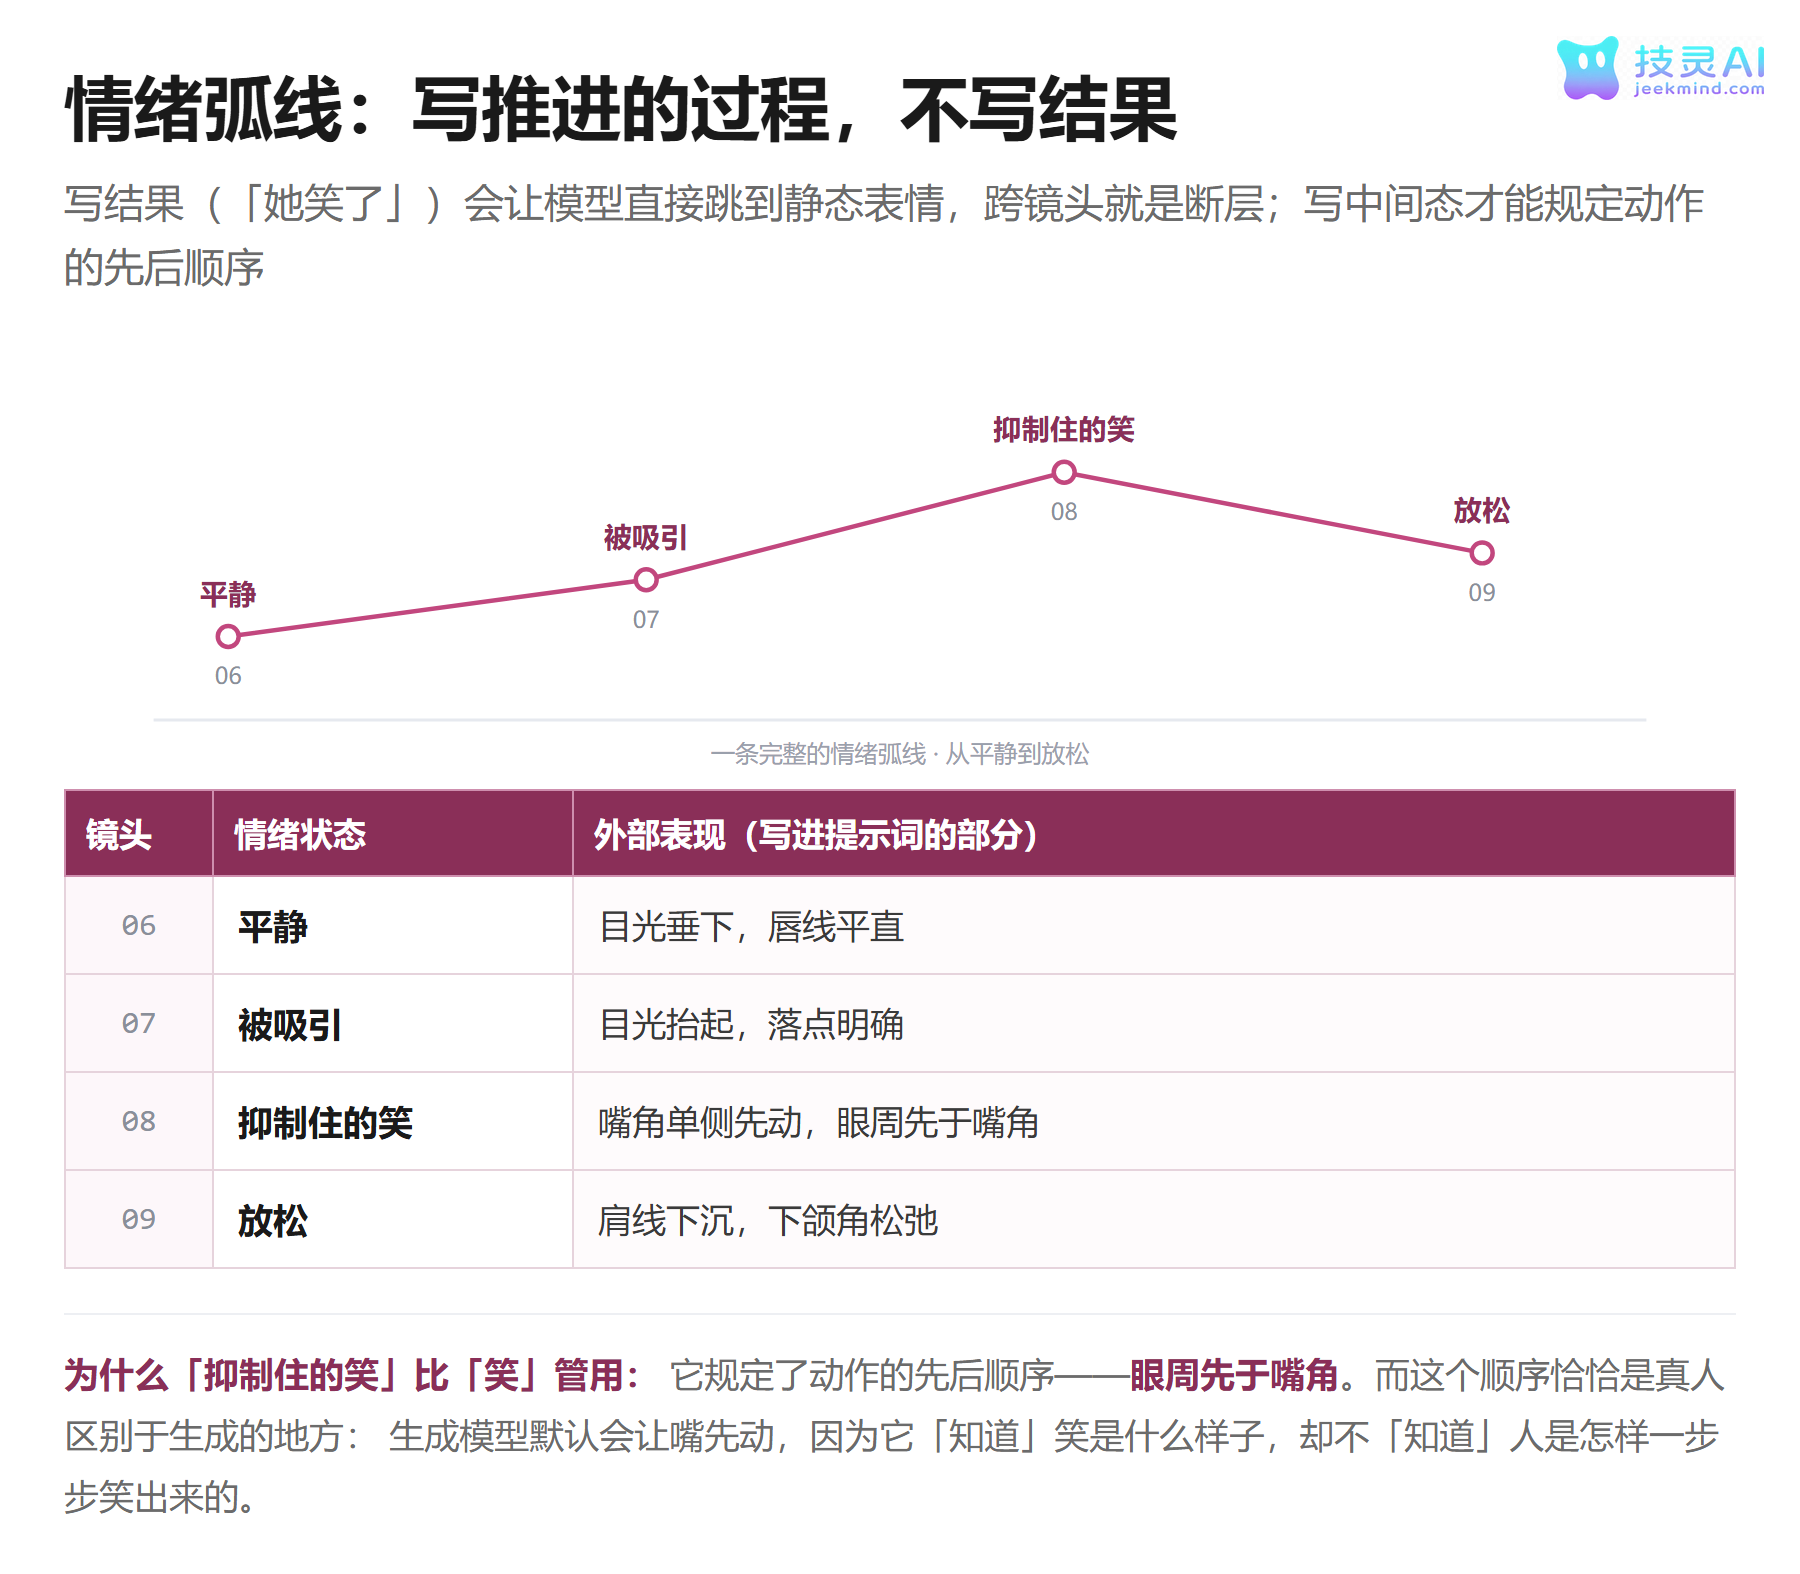
④ 情绪与状态的写法。 不要写「她很开心」,要写从平静到放松的推进过程:目光先抬起,视线落点明确,然后嘴角单侧先动,肩线下沉。写中间态而不是终态,跨镜头时表情才不会断层。
2.2 商品卡
商品卡的标准比模特卡更硬,因为模特可以有一点点变化,商品的外观误差是直接作废:
| 卡内字段 | 内容 | 为什么它是硬约束 |
|---|---|---|
| 包装六面 + 顶底 | 正投影拍摄,不做透视 | 标签朝向、LOGO 位置错一个角度就是另一件商品 |
| 文字细节 | 成分表、批号、刻度、防伪标 | 错一个字,整条素材作废 |
| 材质特写 | 瓶身反光、标签纹理、织物质地、封口 | 观众判断「真假」最快的线索 |
| 使用状态 | 开盖、挤出、余量、佩戴状态 | 「没拆封」和「用了一半」是两个卖点 |
| 尺寸参照 | 手、桌面、常见物件 | 缺参照时模型给出的尺寸会是随机的 |
2.3 一个容易被忽略的分类:固定项 / 可变动 / 剧情态
不管模特卡还是商品卡,字段都得先分成三类,再决定各自能不能改:
- 固定项:脸型、眼睛、肤色、身高、包装整体轮廓、LOGO。任何情况下不许改。
- 可变动项:服装、发型、妆容、场景、光线、季节。可以改,但每次改都必须生成一个新的「已批准状态」,而不是在提示词里临时描述一句。
- 剧情态 / 活动态:淋湿、磨损、换色号、戴帽子、大促贴纸。同样要作为独立状态存下来。
第二类和第三类最常被做错。分镜师为了这一镜好看,顺手在提示词里加了句「戴一顶草帽」,下一镜忘了加,帽子就自己消失了——这不是生成质量问题,是状态没有被登记。
三、偏差出现时,先判断该修哪一件
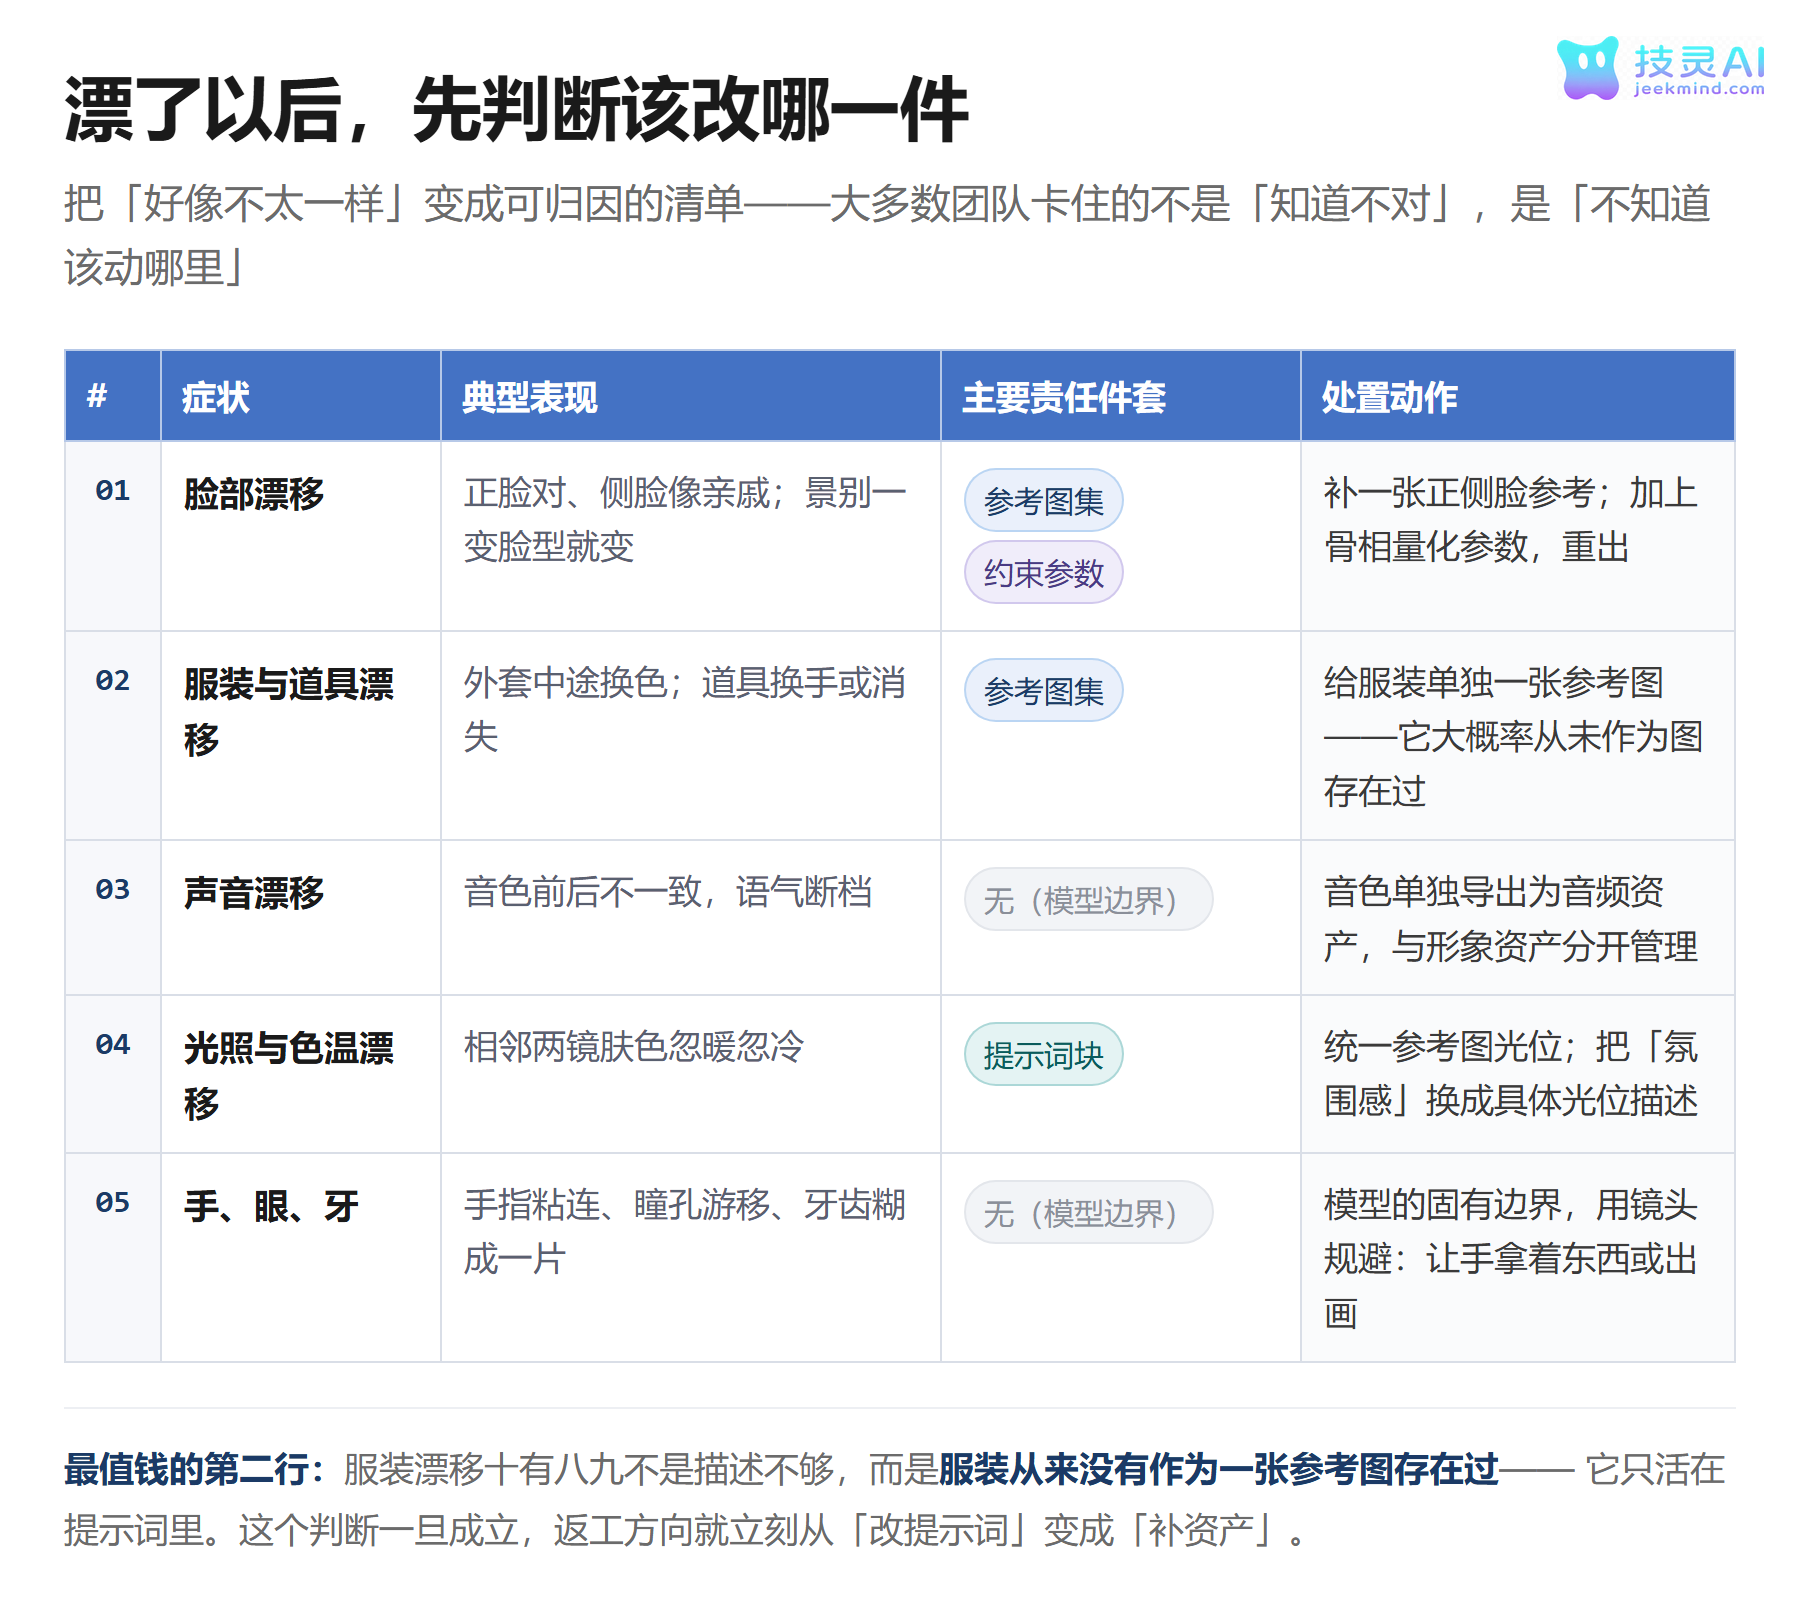
把「好像不太一样」变成可归因的清单,返工效率会高一个量级。同一套资产卡里,不同卡负责压住不同类的偏差:

| 症状 | 典型表现 | 该动哪一件 |
|---|---|---|
| 脸部偏差 | 正脸对、侧脸像亲戚;景别一变脸型就变 | 补正侧脸参考 + 加上骨相约束参数 |
| 服装 / 道具偏差 | 外套中途换色;产品换手或消失 | 给服装单独一张参考图——它大概率从来没作为图存在过,只活在文字里 |
| 声音偏差 | 音色前后不一致,语气断档 | 把音色单独导出成音频资产,与形象分开管理 |
| 光照与色温偏差 | 相邻两镜肤色忽暖忽冷 | 统一参考图光位;把「氛围感」换成具体光位(「画左一盏暖光灯」) |
| 手、眼、牙 | 手指粘连、瞳孔游移 | 属模型固有边界,用镜头规避:让手拿着东西或出画 |
这张表最有用的是最后一列。多数人卡在「知道不对,但不知道该改哪里」——服装类偏差十有八九不是描述不够,而是缺一张图。
四、让资产能被复用,而不是每条片子重建一遍
资产卡的价值全在复用上。而要被复用,就得有规矩。
三条规矩,跟管代码仓库是一个思路:
第一,命名与状态要机器可读。 角色与商品都用小写 ASCII 的 id,下面挂一个元数据文件,写明身份块版本号、批准状态(草稿 / 待审 / 已批准 / 已废弃)、各张参考图的路径。文字块和它控制的图集必须同版本——只改文字不改图,或者只换图不改文字,卡内部就自相矛盾了,而自相矛盾的卡会让模型取平均,结果是漂得更厉害。
第二,外形的任何改动都只走「更新基准资产」这一条路。 不允许在任何一条片子的提示词里就地改描述。这一条是团队协作里最容易崩的地方,也是唯一需要靠纪律而非工具来守的一条。
第三,新项目是「拉资产」,不是「复制资产」。 直接引用同一份卡,不要拷贝一份到新项目。拷贝会产生分叉:两个项目各自演化之后,「同一位模特」变成了两个略有差异的版本——而系列内容最不该出现的,恰好就是这个。
至于「什么时候判定它已经漂了」,这件事需要一点自动化:每生成若干个镜头抽一帧与基准比对,低于阈值时回到基准资产重新锚定,而不是在这一镜上反复重生成。反复重生成会越修越远,因为每一次重生成都是一次新的解释。
五、哪些一致性买不到
有三条边界,最好在立项阶段就讲清楚,不然它会在交付前一周变成争吵。
第一,相似度指标不等于「脸被锁死了」。 公开的量化方案通常用视觉特征的相似度衡量一致性。有一套公开实测给出的数字是:12 段连续镜头的特征相似度均值维持 0.84,到第 12 段仍在 0.77 以上;作为对照,未使用锁定方案的通用模型连续生成 10 组剧情镜头时,外观出现明显偏差的样本占比高于 62%。(该数据来自平台方案的自述实测,属厂商自述口径,不是第三方评测。)这组数字有用,但要带着两条限制读:它衡量的是特征空间的距离,不是「观众认为这是同一个人」——特征距离接近的两帧,在顾客眼里仍可能「像但不是」;而且强逆光、极端表情、大幅度镜头旋转依然会引入偏差。一致性是概率提升,不是绝对零崩坏。
第二,超出一条素材的时长,就变成接戏问题。 单段生成能保证段内的稳定,跨段仍然要靠首尾帧之类的机制去接。这不是资产卡能解决的,属于另一条工序。
第三,合规约束先于一切技术手段。 涉及真人的形象,肖像与声音需要书面授权并留存可查;生成内容需要按现行要求添加标识。这几条是硬线,不属于「优化空间」。
六、小结
回到开头那个具体的问题:同一位模特怎么在二十条短视频里都是同一个人?
答案不是「拍得更细」或者「写得更准」,而是在第一条片子开工之前,先把模特和商品各自做成一张卡:多角度图集、逐字复用的描述块、可量化的约束参数、明确的情绪与状态写法。之后每一条片子,都是从卡里调用,而不是重新描述一遍。
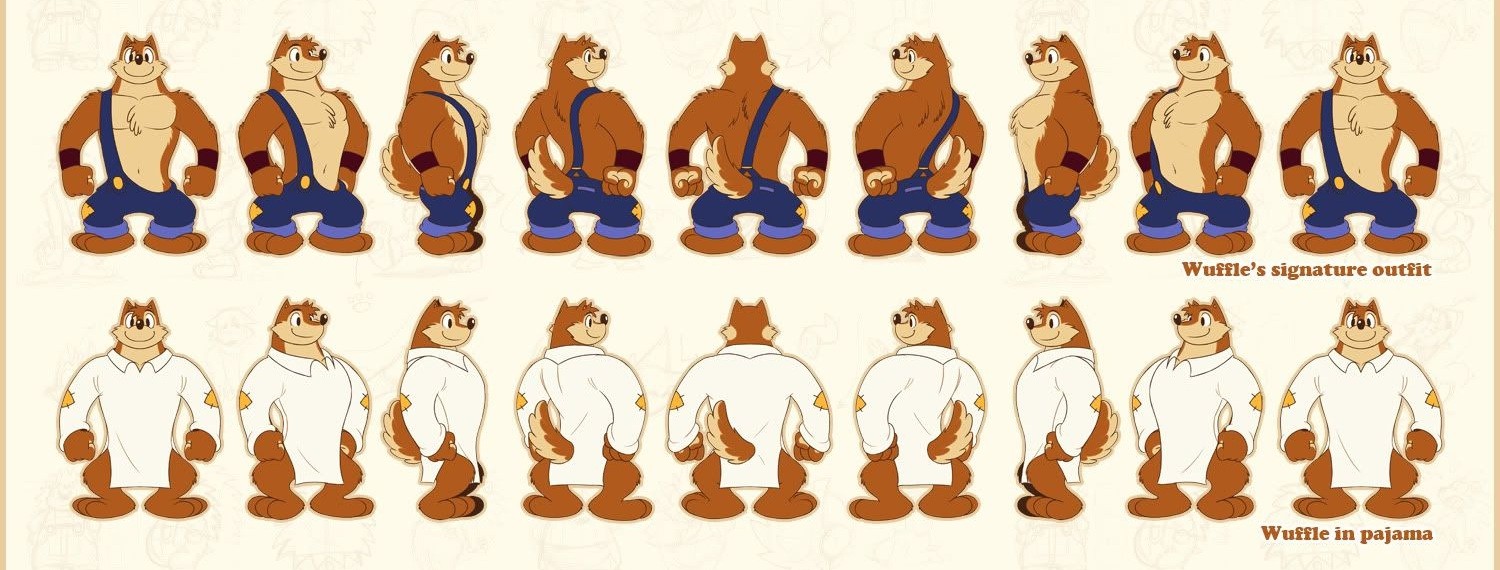
这套做法的门槛不在技术上,在顺序上:先立资产,再写提示词,最后才是校验。绝大多数团队的顺序是反的——先不停改提示词,改不动了才补参考图,等出了成片再人工找哪一镜不对。顺序反了,后面每一步都在替第一步还债。
行业侧的参照也能说明这一点。义乌饰品产业带已经有平台把「模特佩戴图」做成批量能力,公开报道提到有商家使用后出图效率提升 90%、成本直降 96%,其中一位珠宝商借助 AI 生成个性化场景图每年节省拍摄费用五六十万元,并用自己女儿的形象塑造个人 IP(报道中转述的商家自述数据)。最后这半句是关键:她要的不是「一张好看的图」,是一个能在几百条素材里都认得出来的形象——这正是资产卡要解决的问题,只不过在电商语境里,角色的名字叫「品牌模特」或「主理人形象」。
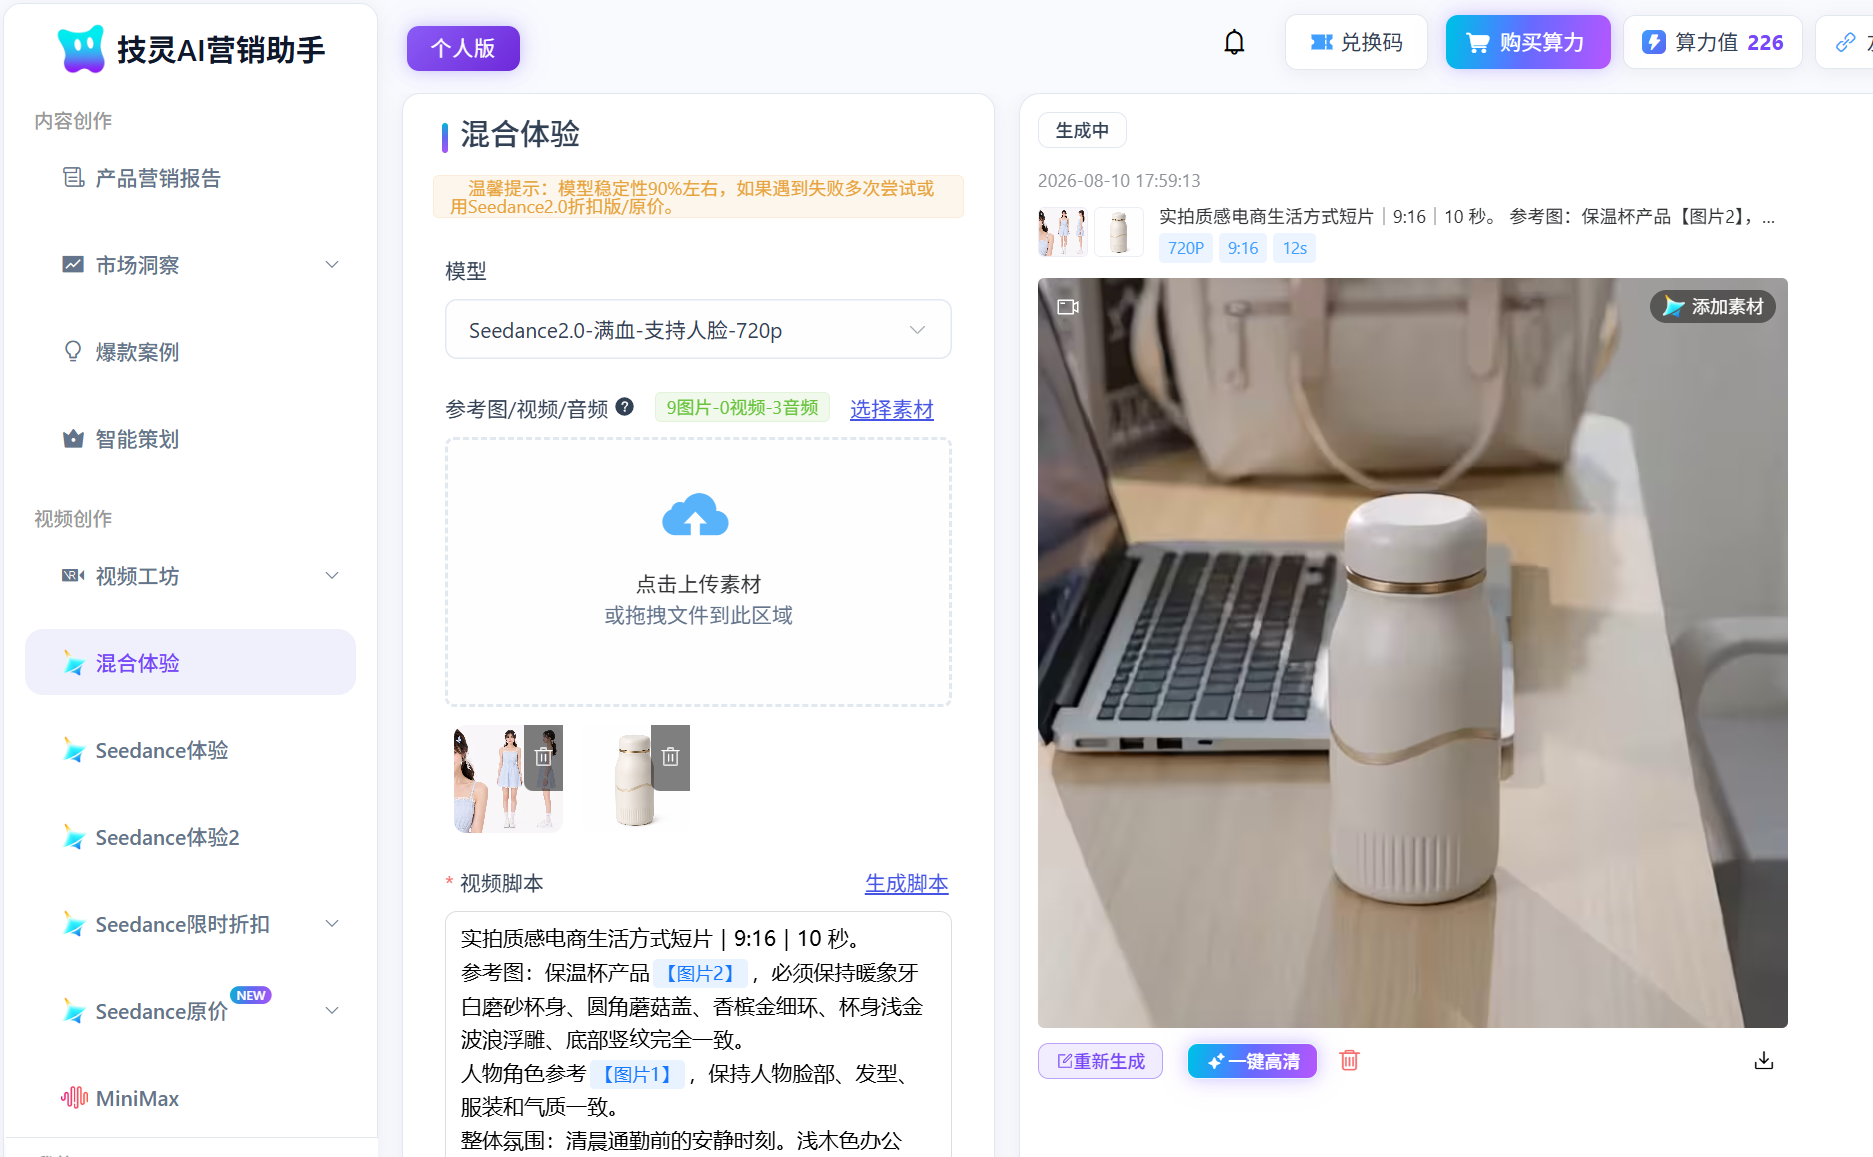
技灵AI 把这条路径做成了产品能力:一站式 AI 电商内容生产平台。无限画布提供节点式工作流,同一项目或系列中的角色、场景与风格可以在画布中反复调用,用来保证系列内容的一致性,角色与场景资产自动沉淀、支持多人协作;IP 吉祥物设计可按品牌调性生成主形象并自动产出正、侧、背三视图,正好对应资产卡里的「多角度图集」这一件;视频生成侧接入 Seedance 2.5(支持人脸)、Seedance 2.0 满血等档位,形象素材审核入库后可以反复取用;图片创作侧的电商产品图支持商品图换背景、换模特,把「同一件商品、同一位模特在多版素材里保持一致」变成可以批量执行的动作。