AI 长剧的角色、场景、镜头怎么保持连续?拆解《后西游记》的 Seedance 生产流程
2026 年 8 月 31 日,一部 30 集的 AIGC 长剧《后西游记》登陆湖南卫视黄金档与芒果 TV。全片没有一位真人演员,画面与人物演绎 100% 由 Seedance 系列模型生成。
媒体关注的是"成本降到十分之一""芒果超媒连续两个涨停"。但对真正要动手做这件事的团队来说,更值得盯住的是另一组数字:
109 个角色数字资产,143 个场景数字资产。
这组数字说明了一件事——这部片子不是"生成"出来的,是**"管理"**出来的。
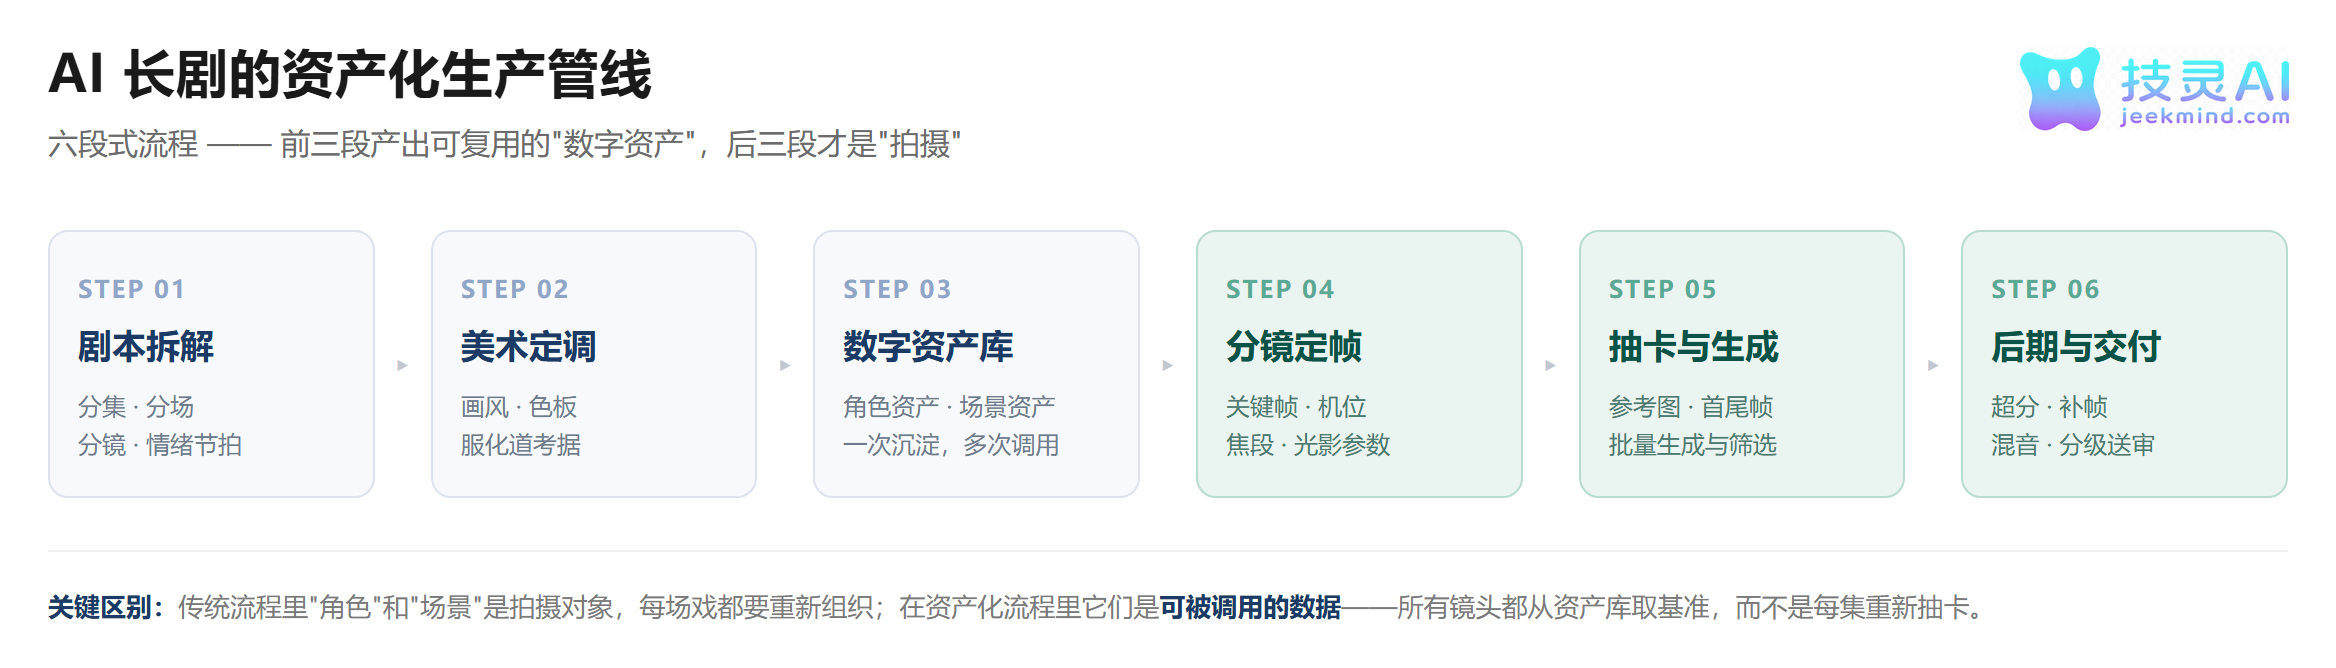
图 1:国内首部登陆卫视黄金档的全 AIGC 长剧,第一季"花果山篇"的公开数据
一、为什么"抽卡"撑不起一部长剧
做一条 15 秒的 AI 视频,难点在提示词。做一部 30 集、每集 40 分钟的长剧,难点完全换了地方。
长剧会崩,从来不是因为"某一帧画得不好看",而是因为同一个东西在镜头之间发生了变化。具体来说是三种漂移:
- 角色漂移:上一集的脸,这一集认不出来了。发型、五官、体型、服饰细节在不知不觉中滑走。
- 场景漂移:同一个空间,换个机位就不是同一个地方了。墙上的裂纹、窗棂的形制、光从哪里来,全变了。
- 镜头断点:两个镜头单看都没问题,接在一起就穿帮。人物行进方向反了,道具换了只手,上一秒黄昏下一秒正午。
这三件事有一个共同点:它们都不是在生成环节能解决的,必须在生成之前锁死。
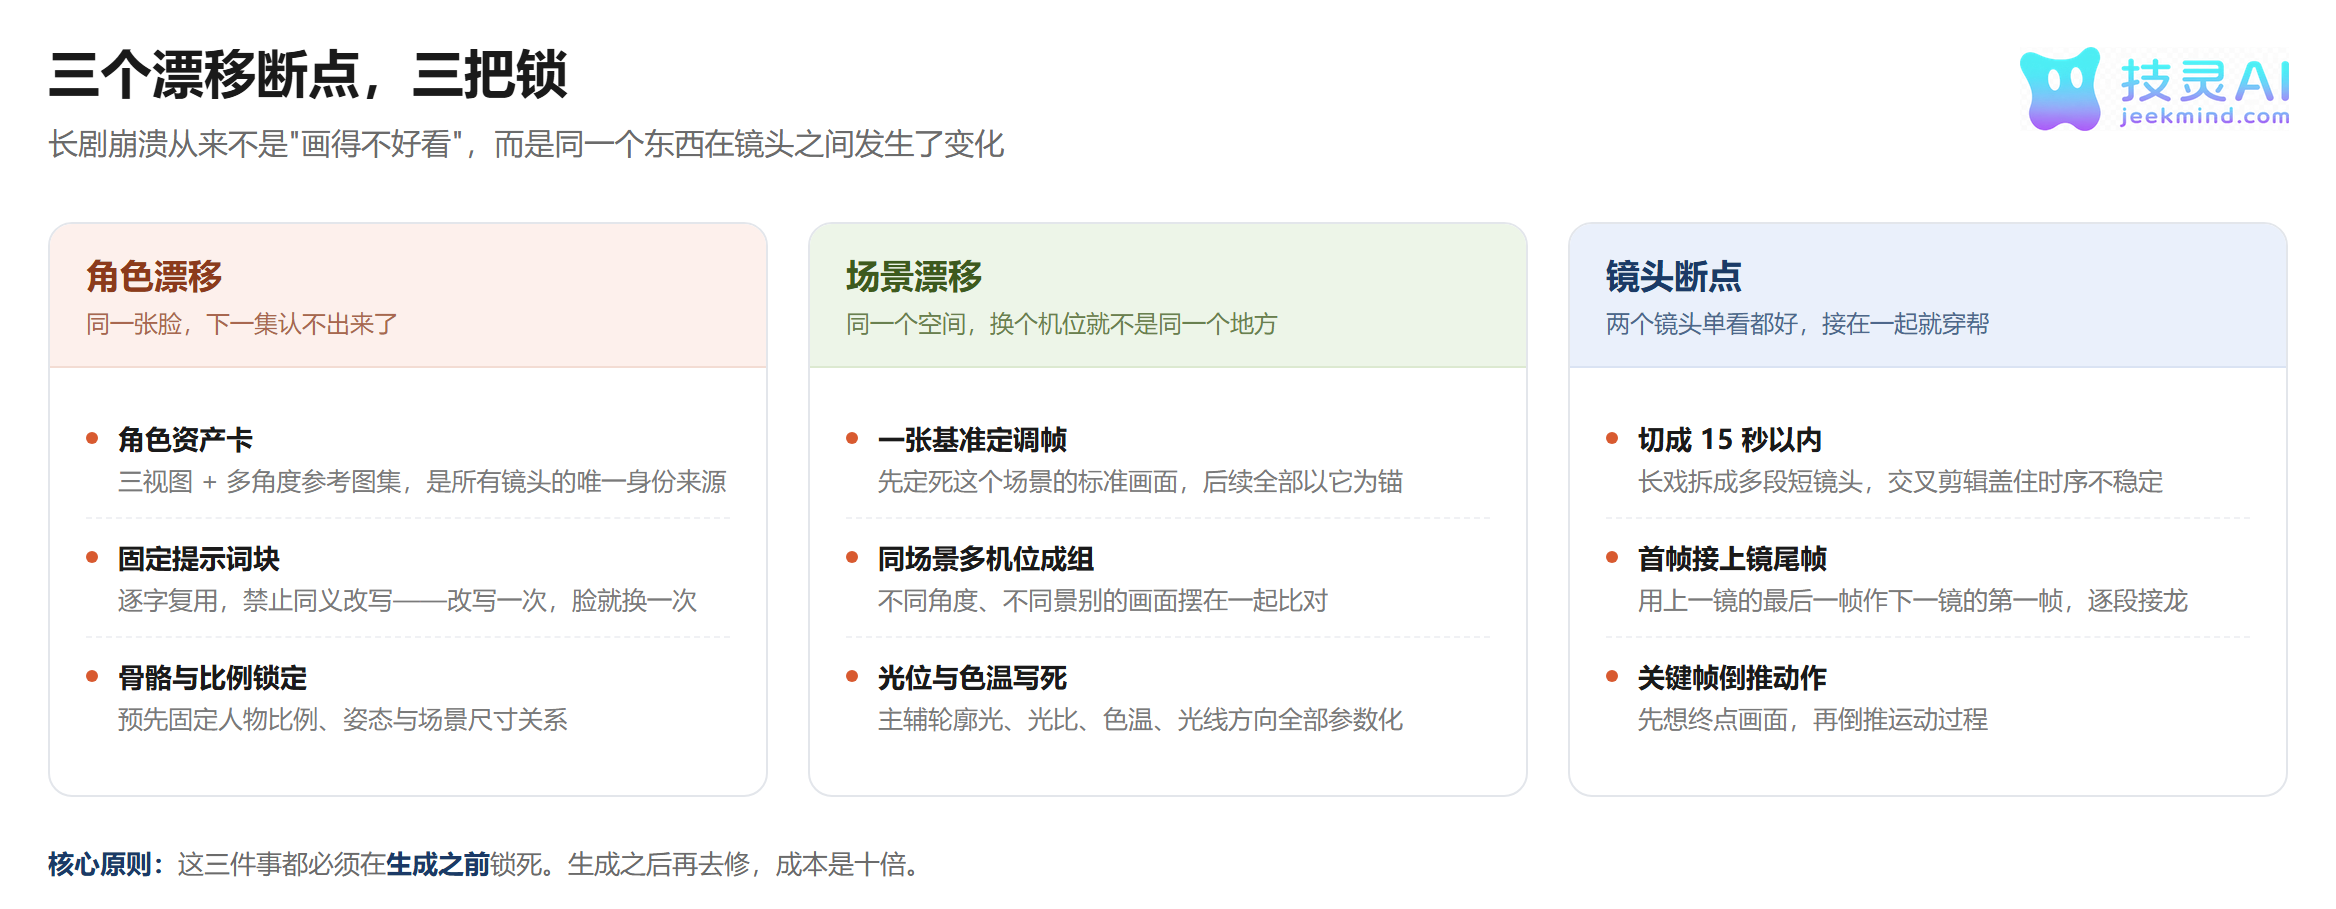
图 2:长剧崩溃的三种方式,以及对应的锁定手段
二、六段式资产化管线
把这套逻辑展开,就是一条件清晰的流水线。
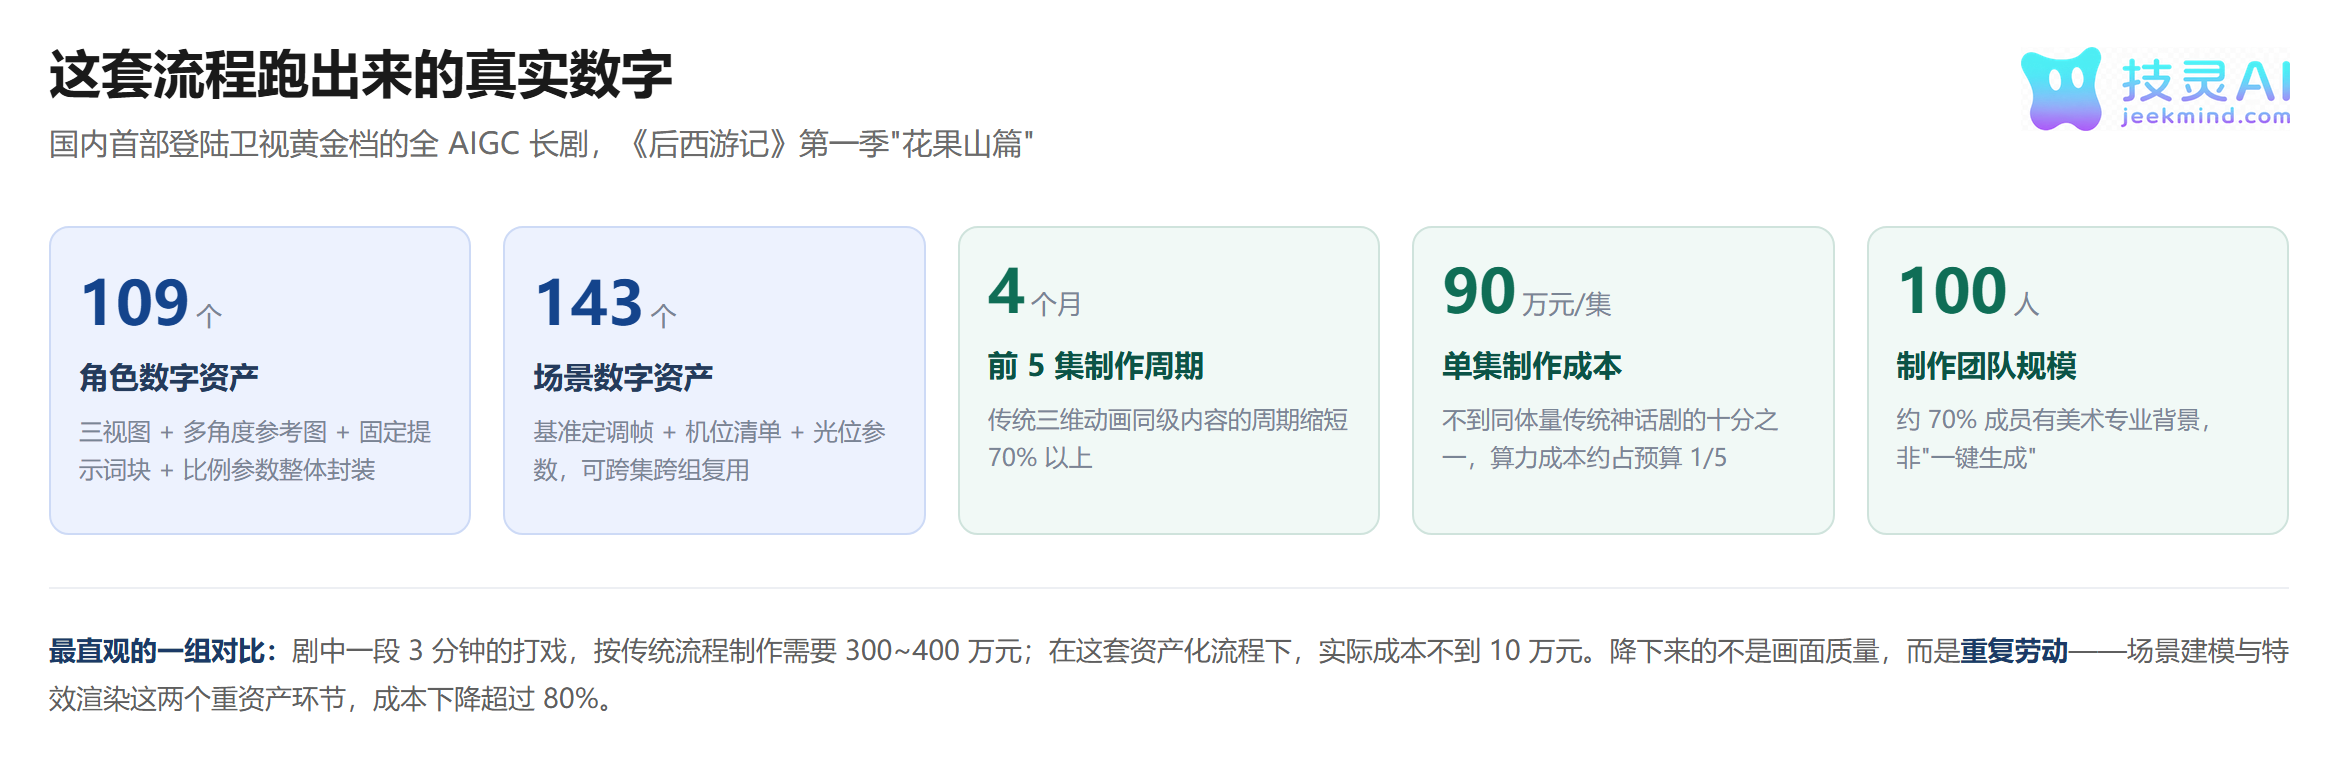
图 3:前三段产出可复用的"数字资产",后三段才是真正意义上的"拍摄"
注意前三段和后三段的分工差异。传统影视流程里,"角色"和"场景"是拍摄对象,每一场戏都要重新把演员请回来、把景搭起来;在资产化流程里,"角色"和"场景"变成了可被调用的数据。
区别在成本结构上会放大得极其惊人:
- 传统流程:演员档期、场地、置景、灯光,这些成本随场次数线性增长。
- 资产化流程:资产搭建是一次性投入,之后每一场戏的成本只剩算力。场景建模与特效渲染这两个重资产环节,成本下降超过 80%。
剧中一段 3 分钟的打戏,按传统三维动画流程制作需要 300~400 万元;在这套流程下,实际成本不到 10 万元。降下来的不是画面质量,是重复劳动。
三、角色怎么连续生产
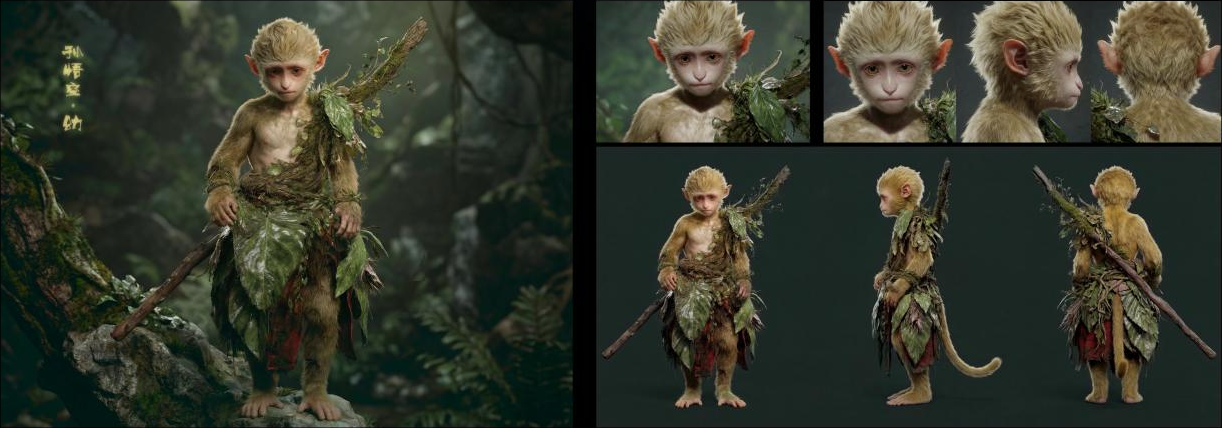
角色一致性的最小单位不是提示词,而是一张角色资产卡。
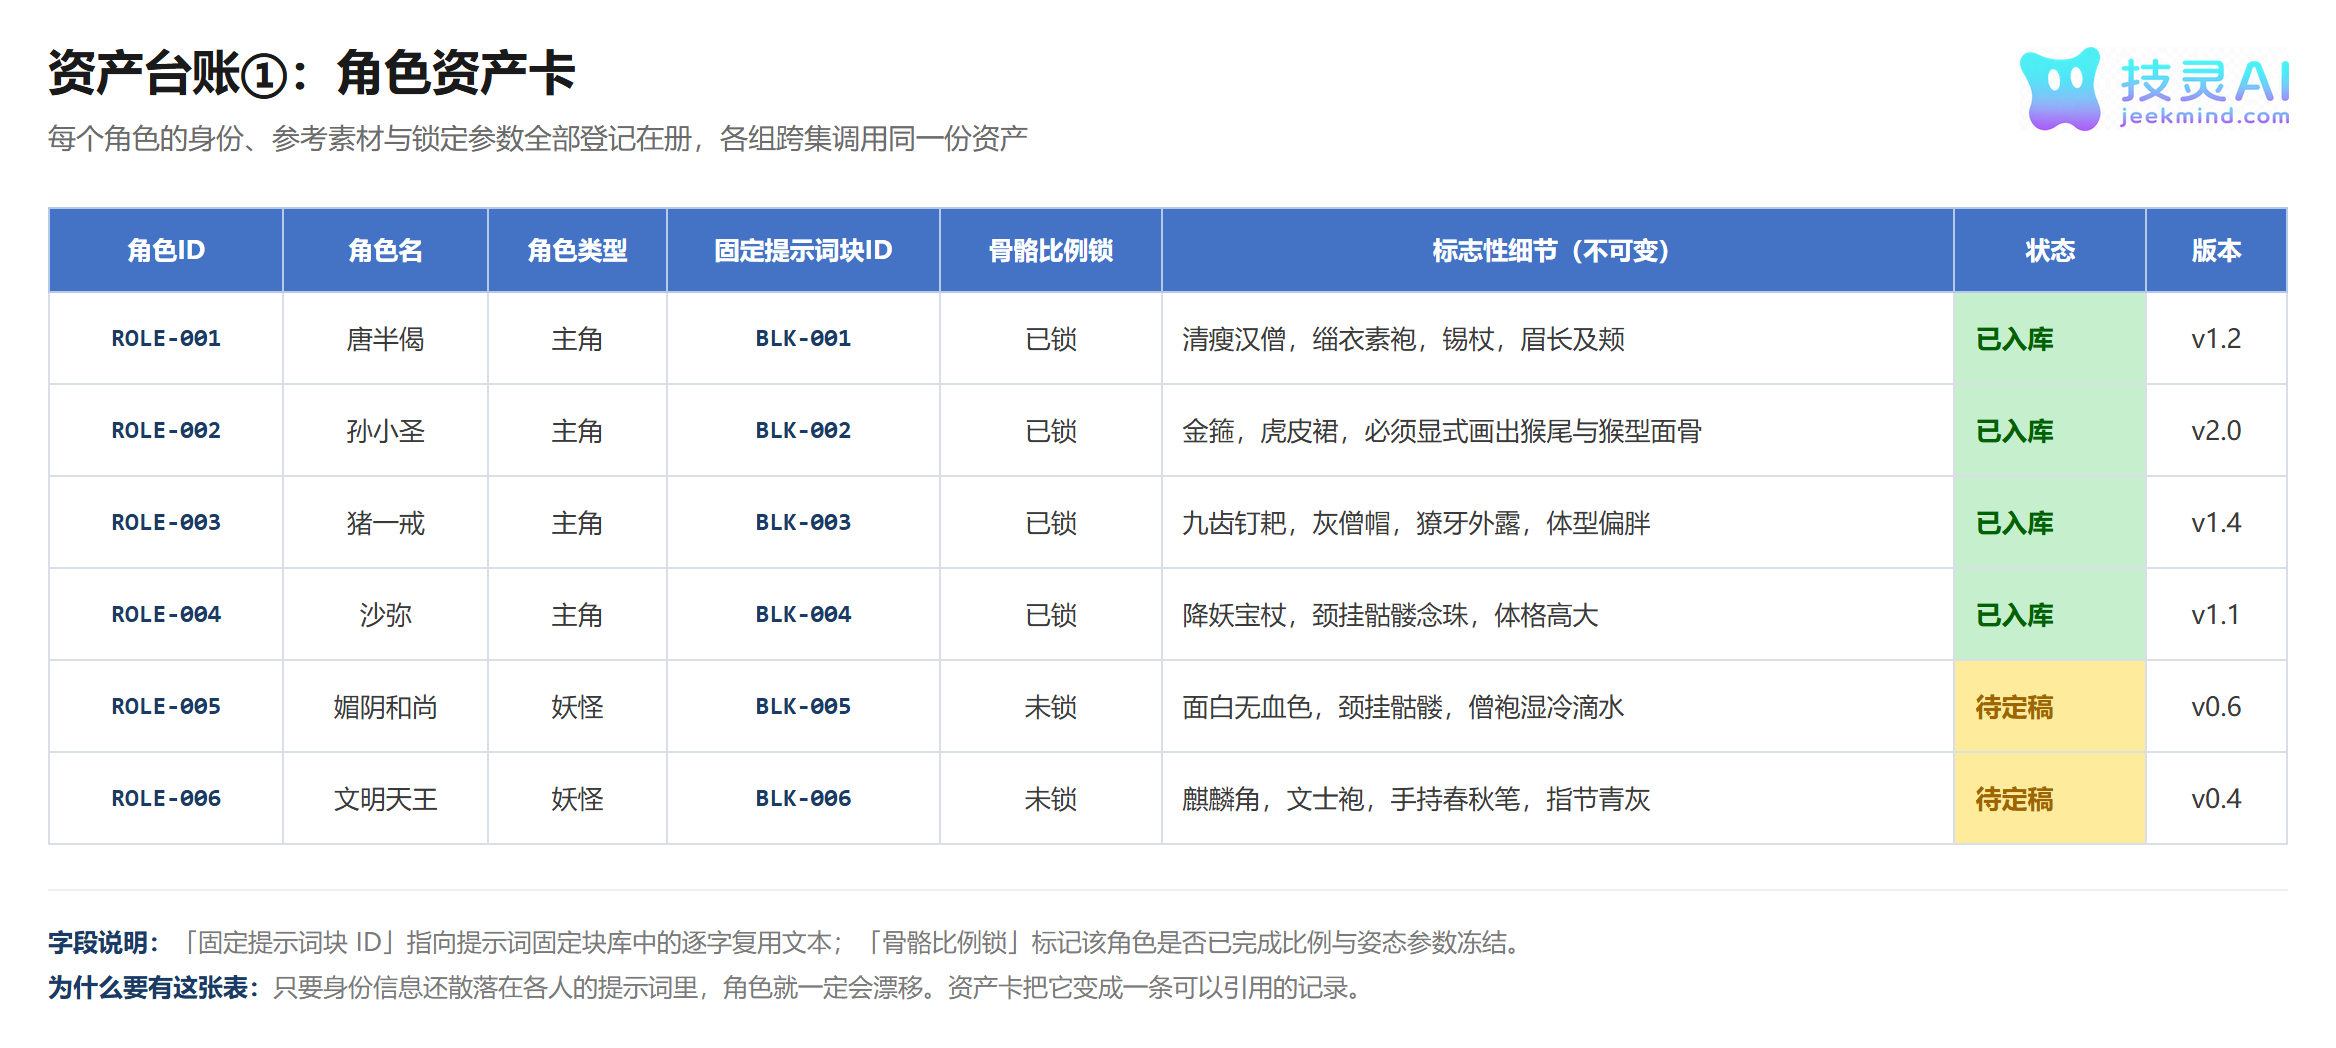
图 4:每个角色的身份、参考素材与锁定参数全部登记在册
一张完整的角色资产卡包含四件套:
- 三视图 + 多角度参考图集:正面、四分之三侧、侧面,以及关键特征的特写。图集越干净、角度越全,模型泛化越稳。
- 固定提示词块:描述外貌、服饰、体态的那段文字,逐字复用,禁止同义改写。改写一次,脸就可能换一次。
- 骨骼与比例参数:预先固定人物比例、姿态与场景尺寸的关系,从根源上规避肢体比例崩坏。
- 不可变细节清单:那些一旦缺失就会导致整段表演失真的标志性特征。
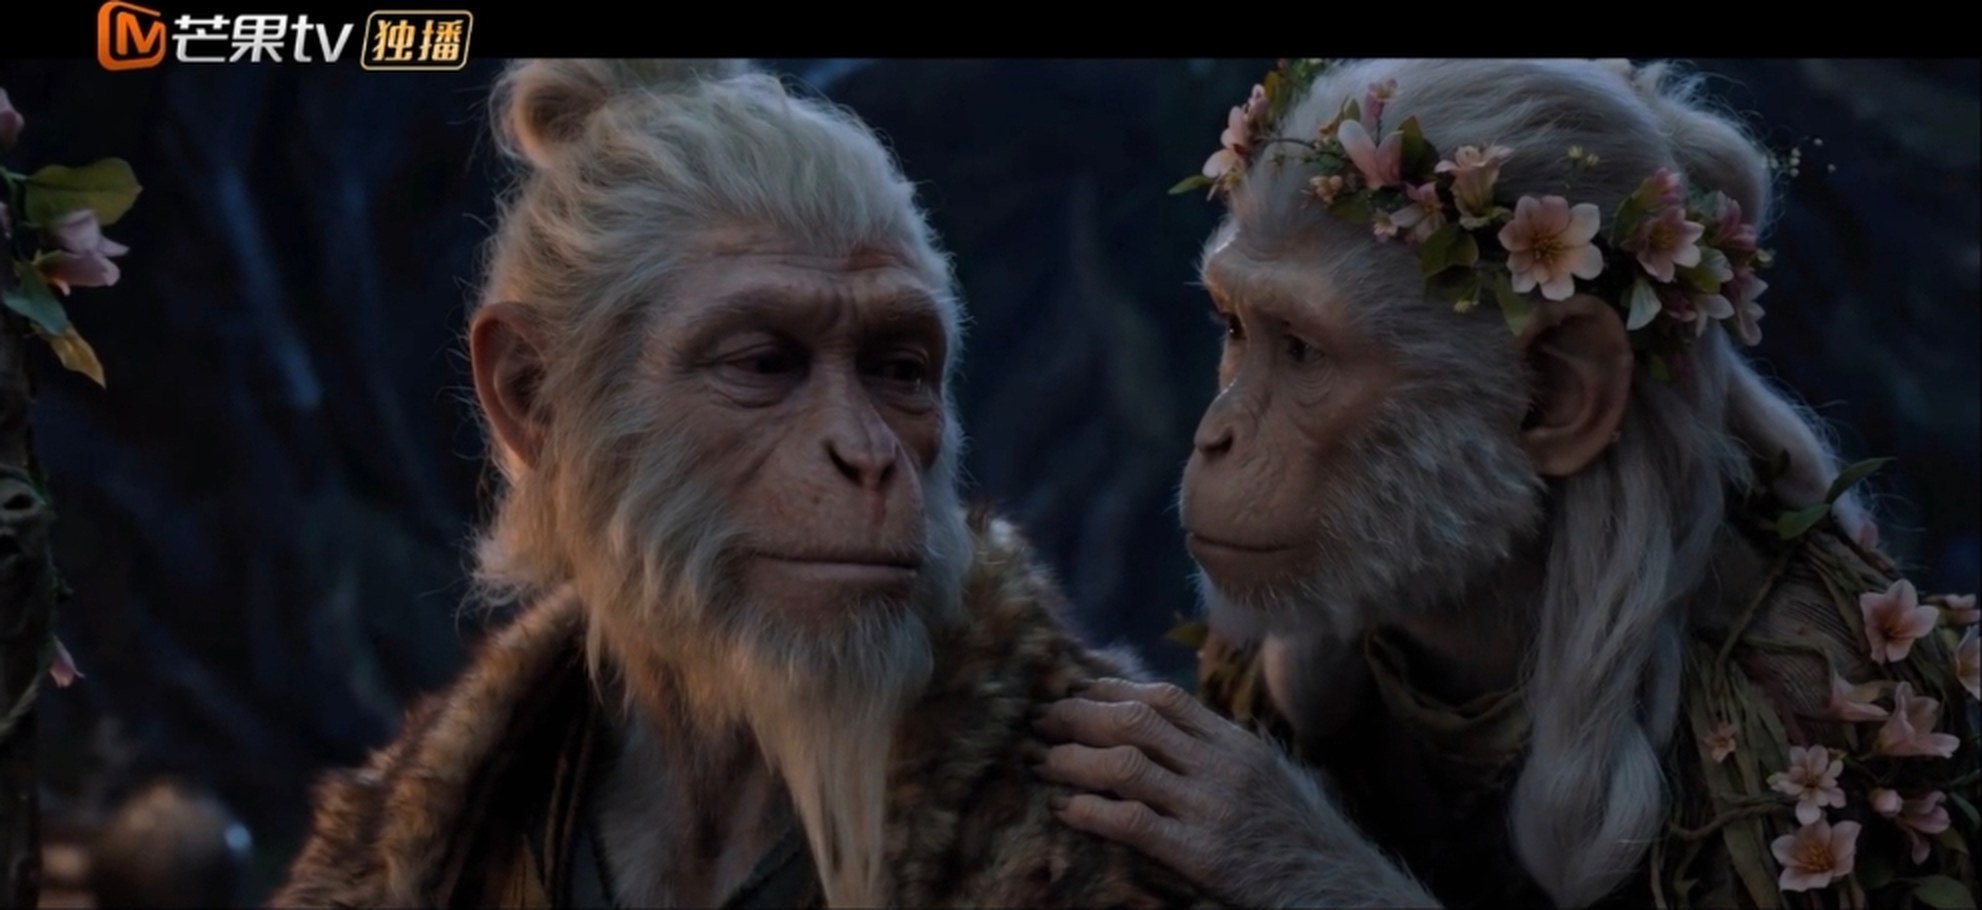
一个真实案例:孙小圣的尾巴
这不是理论推演。制作团队在某一集的关键戏份上遇到了一个诡异的问题:相同的提示词、相同的模型、相同的抽卡师,产出的人物表演突然变得僵硬——面部表情和肢体动作都不对。
排查了十天,问题锁定在人设图上:孙小圣最初的设计图没有画尾巴。
模型看到一只没有尾巴的"猴子",判定这是人类演员在扮演猴子,于是默认面部覆盖着假体、不能做大幅度表情。而猴子的尾巴在这个认知框架里成了"服装道具"。补上尾巴之后,模型正确识别为猴子本体,角色表演立刻恢复正常。
这件事的判断价值在于:模型有自己的认知逻辑,它不读你的意图,它读你的输入。 设定图上少一个元素,模型不会问你,它会自己补一个前提——然后整段表演都建立在这个错误前提上。
情绪也要写"弧线",而不是写结果
另一个容易被忽略的点是情绪的写法。
不能写"让他笑""让他哭",而要告诉模型这场戏的情绪从 A 点到 B 点如何推进。模型理解了情绪脉络,生成的内容才有"人的温度"。
这也是"AI 影视"和"AI 视频"的分水岭:前者需要的是表演,后者只需要画面。
四、场景怎么连续生产
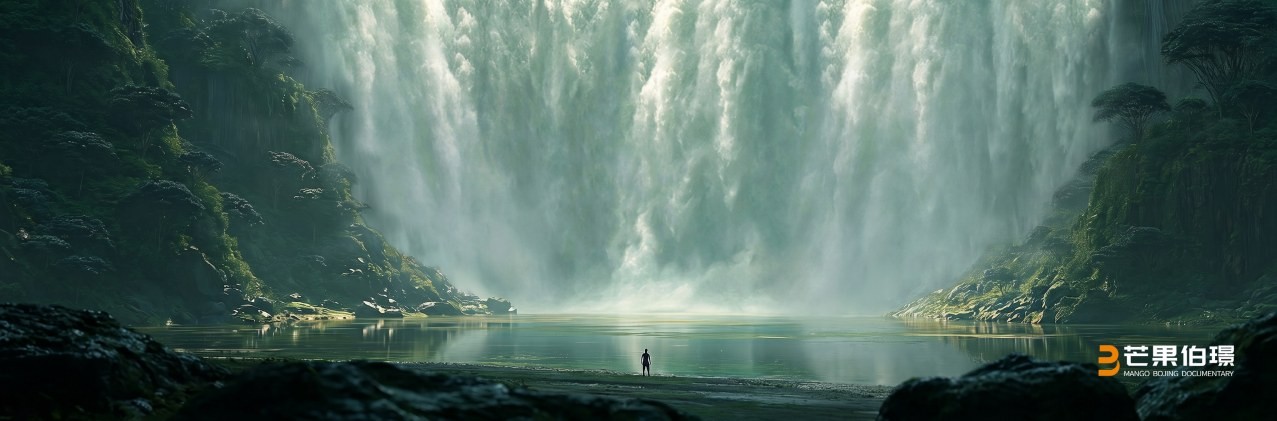
场景不是一个"背景描述",而是一张基准定调帧加一组参数。
每场戏都把场景基准帧和人设图一起挂进生成请求,在已经确定的视觉基准上做图生视频,而不是从零开始发散。这是一条硬纪律——只要允许模型"自由发挥"一次,这个场景就不再是同一个场景。
配套的还有三件事:
- 同场景多机位成组评审:把同一场景在不同角度、不同景别下生成的画面摆在一起对比着看,确认这个空间在各个视角下都是连贯的。
- 光位参数写死:主光、辅光、轮廓光、光比、色温、光线方向全部参数化。光源方向一变,观众的空间感立刻错乱。
- 时间与天光统一:同一场戏的日夜、天气、时刻必须一致。
还有一个非常务实的经验:场景选材本身可以"讨巧"。 树林、竹林、洞穴这类不同机位差异天然不大的场景,一致性难度要低得多;而结构复杂、细节繁多的室内空间,一致性成本会直线上升。在剧本阶段就把这个因素纳入考量,比在生成阶段死磕要划算。
五、镜头怎么连续生产
这是工程难度最高的一层。
首尾帧接戏
做法是:每一镜切成 15 秒以内(多数在 6~8 秒),上一镜的最后一帧直接作为下一镜的第一帧。
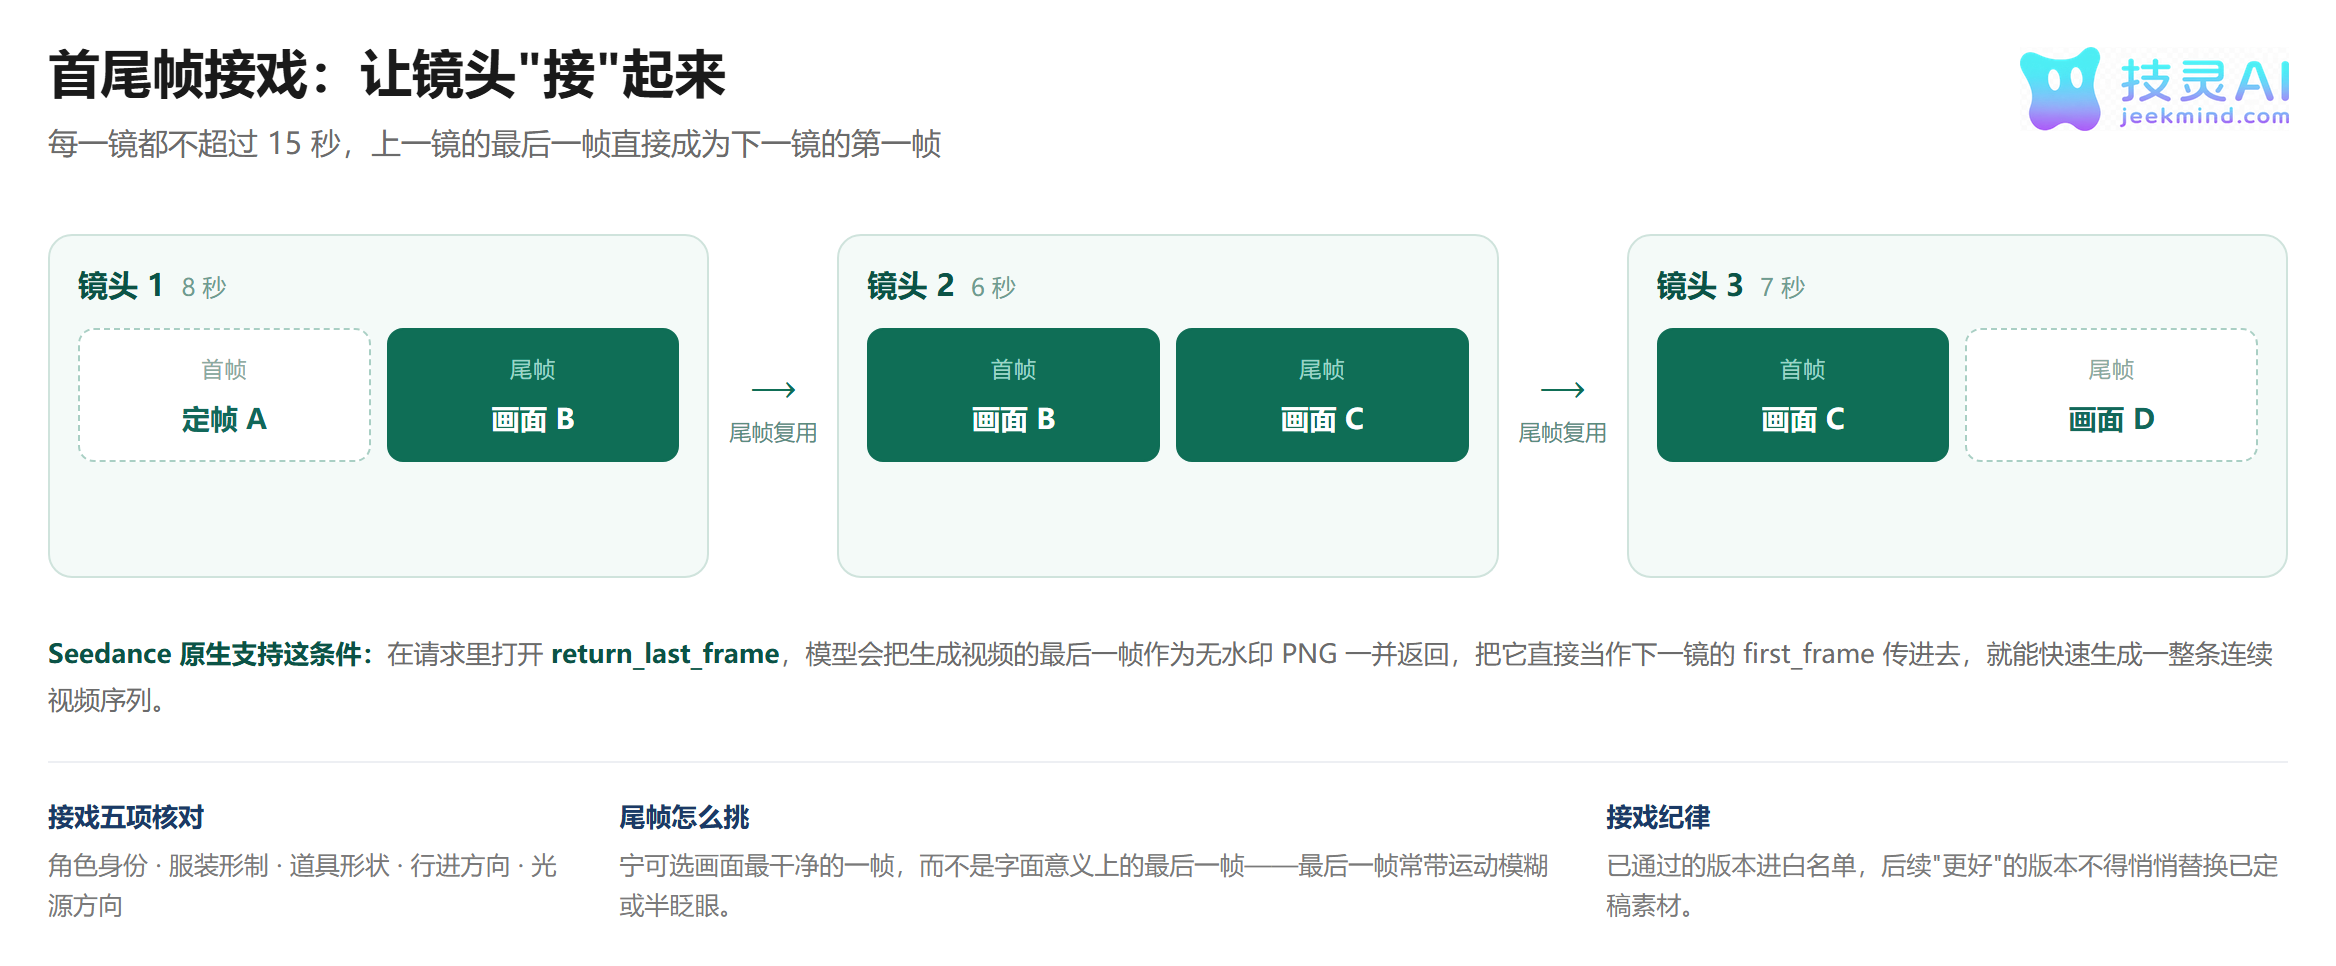
图 5:逐段接龙的工作方式
Seedance 原生支持这条链路:在请求中打开 return_last_frame,模型会把生成视频的最后一帧作为无水印 PNG 一并返回,把它直接当作下一镜的 first_frame 传进去,就能快速生成一整条连续的序列。
两个必须知道的注意点:
- 接戏会累积误差。 链条越长,单帧重建身份的偏差越容易被放大。所以每几段就要回到资产卡的参考图重新锚定一次,而不是无限接龙。
- 尾帧宁可选"干净"的一帧,而不是字面意义上的最后一帧。 一条视频的最后一帧常常是最糟的一帧——运动模糊、半眨眼、嘴型停在单词中间。
把接戏链条记录在案
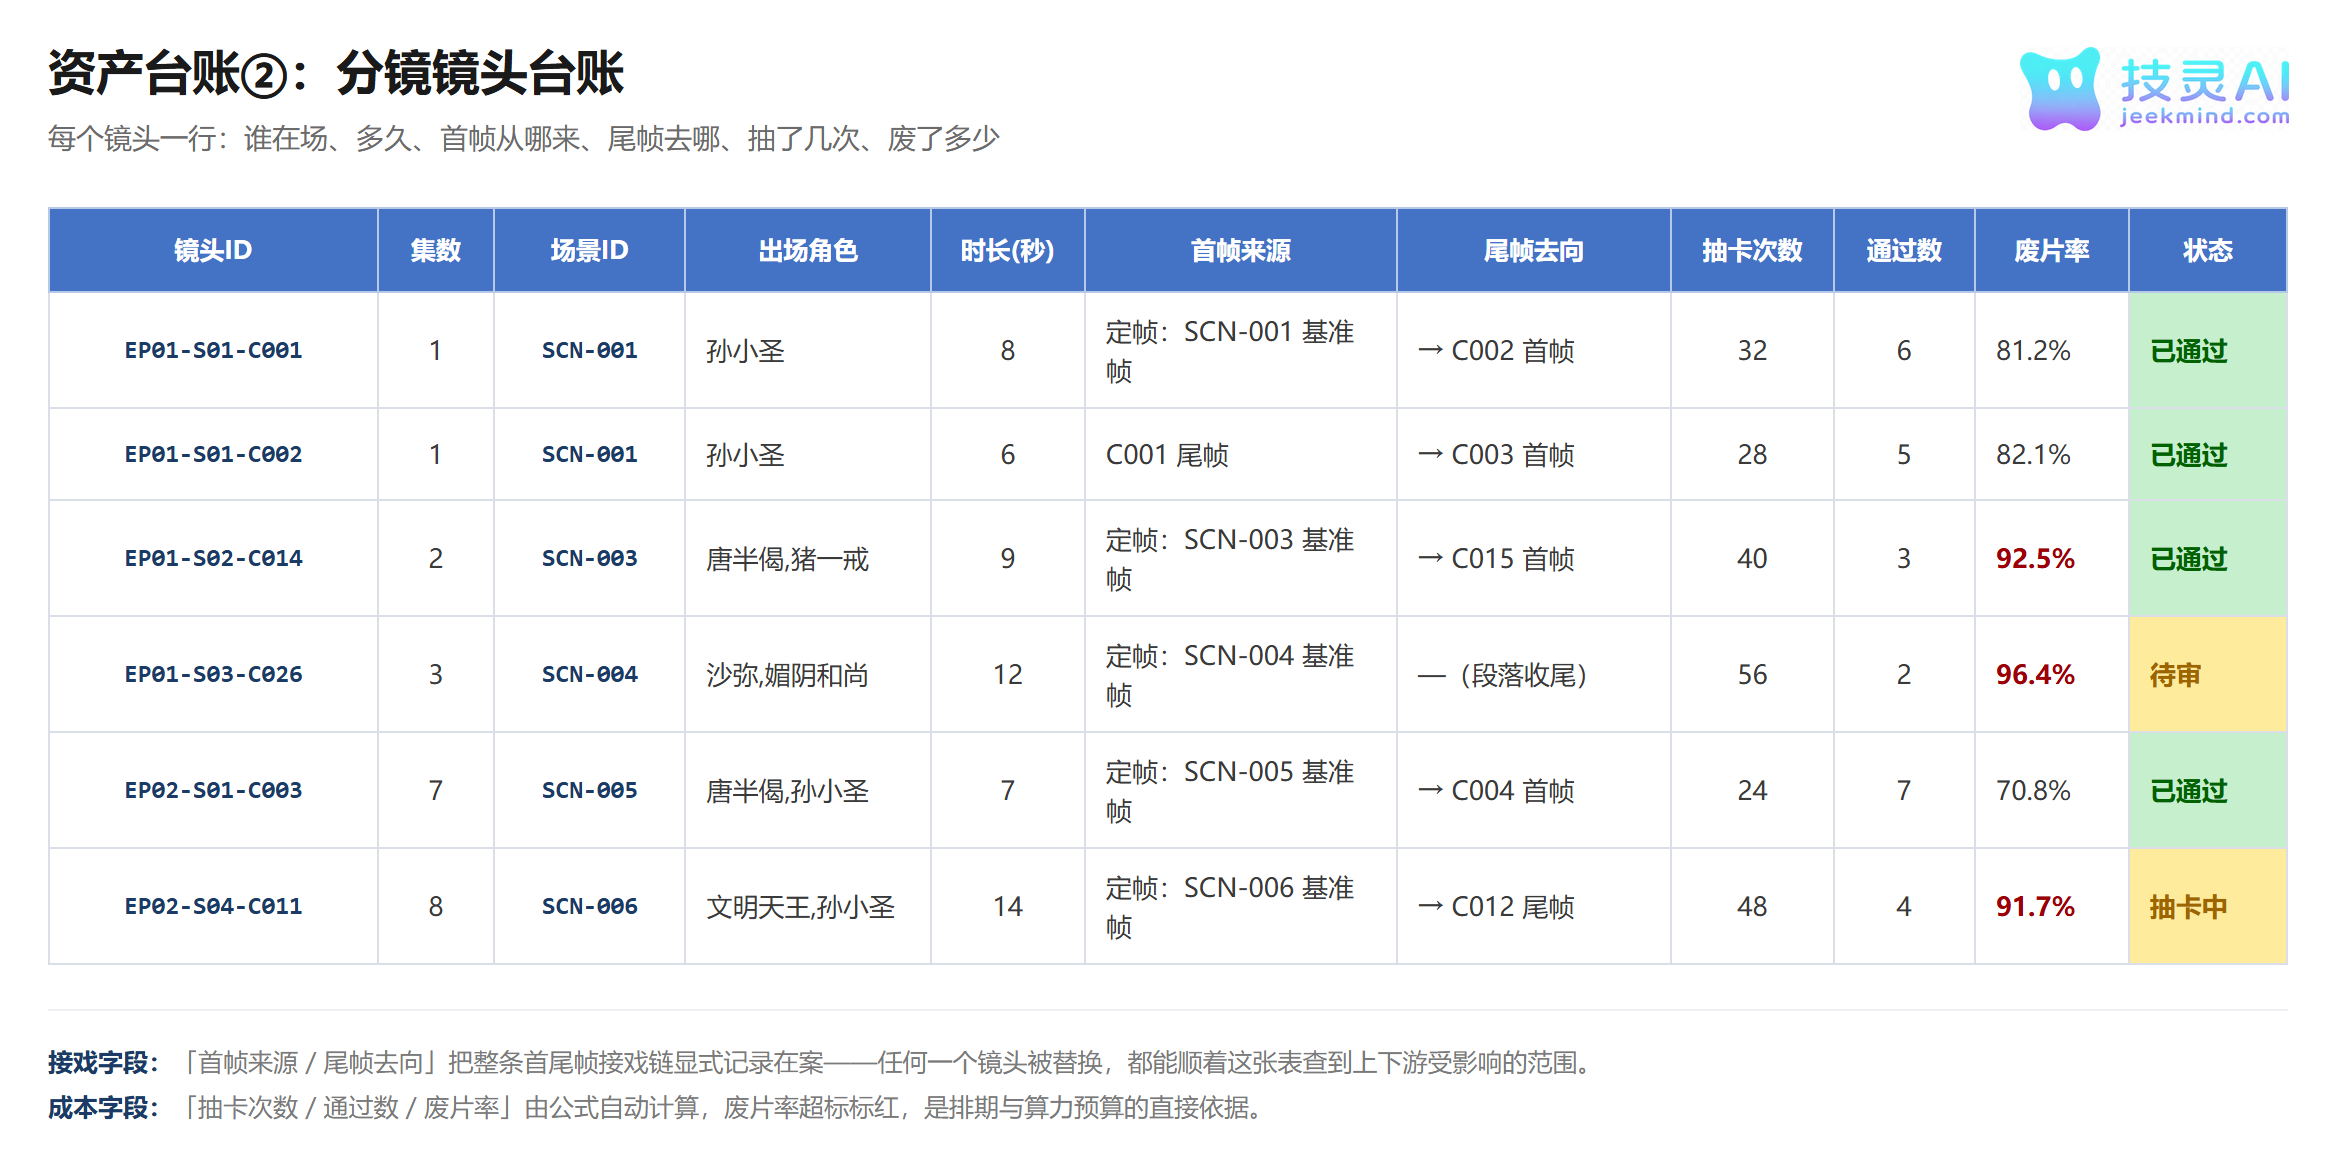
图 6:每个镜头一行,首帧从哪来、尾帧去哪,全部显式登记
"首帧来源 / 尾帧去向"这两列的价值在于:任何一个镜头被替换,你都能顺着台账查到上下游受影响的范围。 没有这张表,一次改动就会变成一次全段落重来。
定帧逻辑,而不是摄影机逻辑
传统影视里,导演站在摄影机后面调度一切。在这套流程里,摄影机消失了,取而代之的是一个个被精确设定的关键帧。
主创团队的说法很准确:导演可以先想象终点画面,再倒推动作。叙事本身仍然由编剧和导演掌控,改变的只是执行方式——从"摄影机逻辑"转向"定帧逻辑"。
时序不稳定,用剪辑盖住
AI 生成内容的时序稳定性仍然是个问题,而这恰恰是剪辑能补齐的短板:把长戏拆成好几个短镜头交叉剪在一起,靠剪辑节奏把问题盖过去。
六、谁来干这些活
AI 没有让剧组变小,只是让岗位变了。
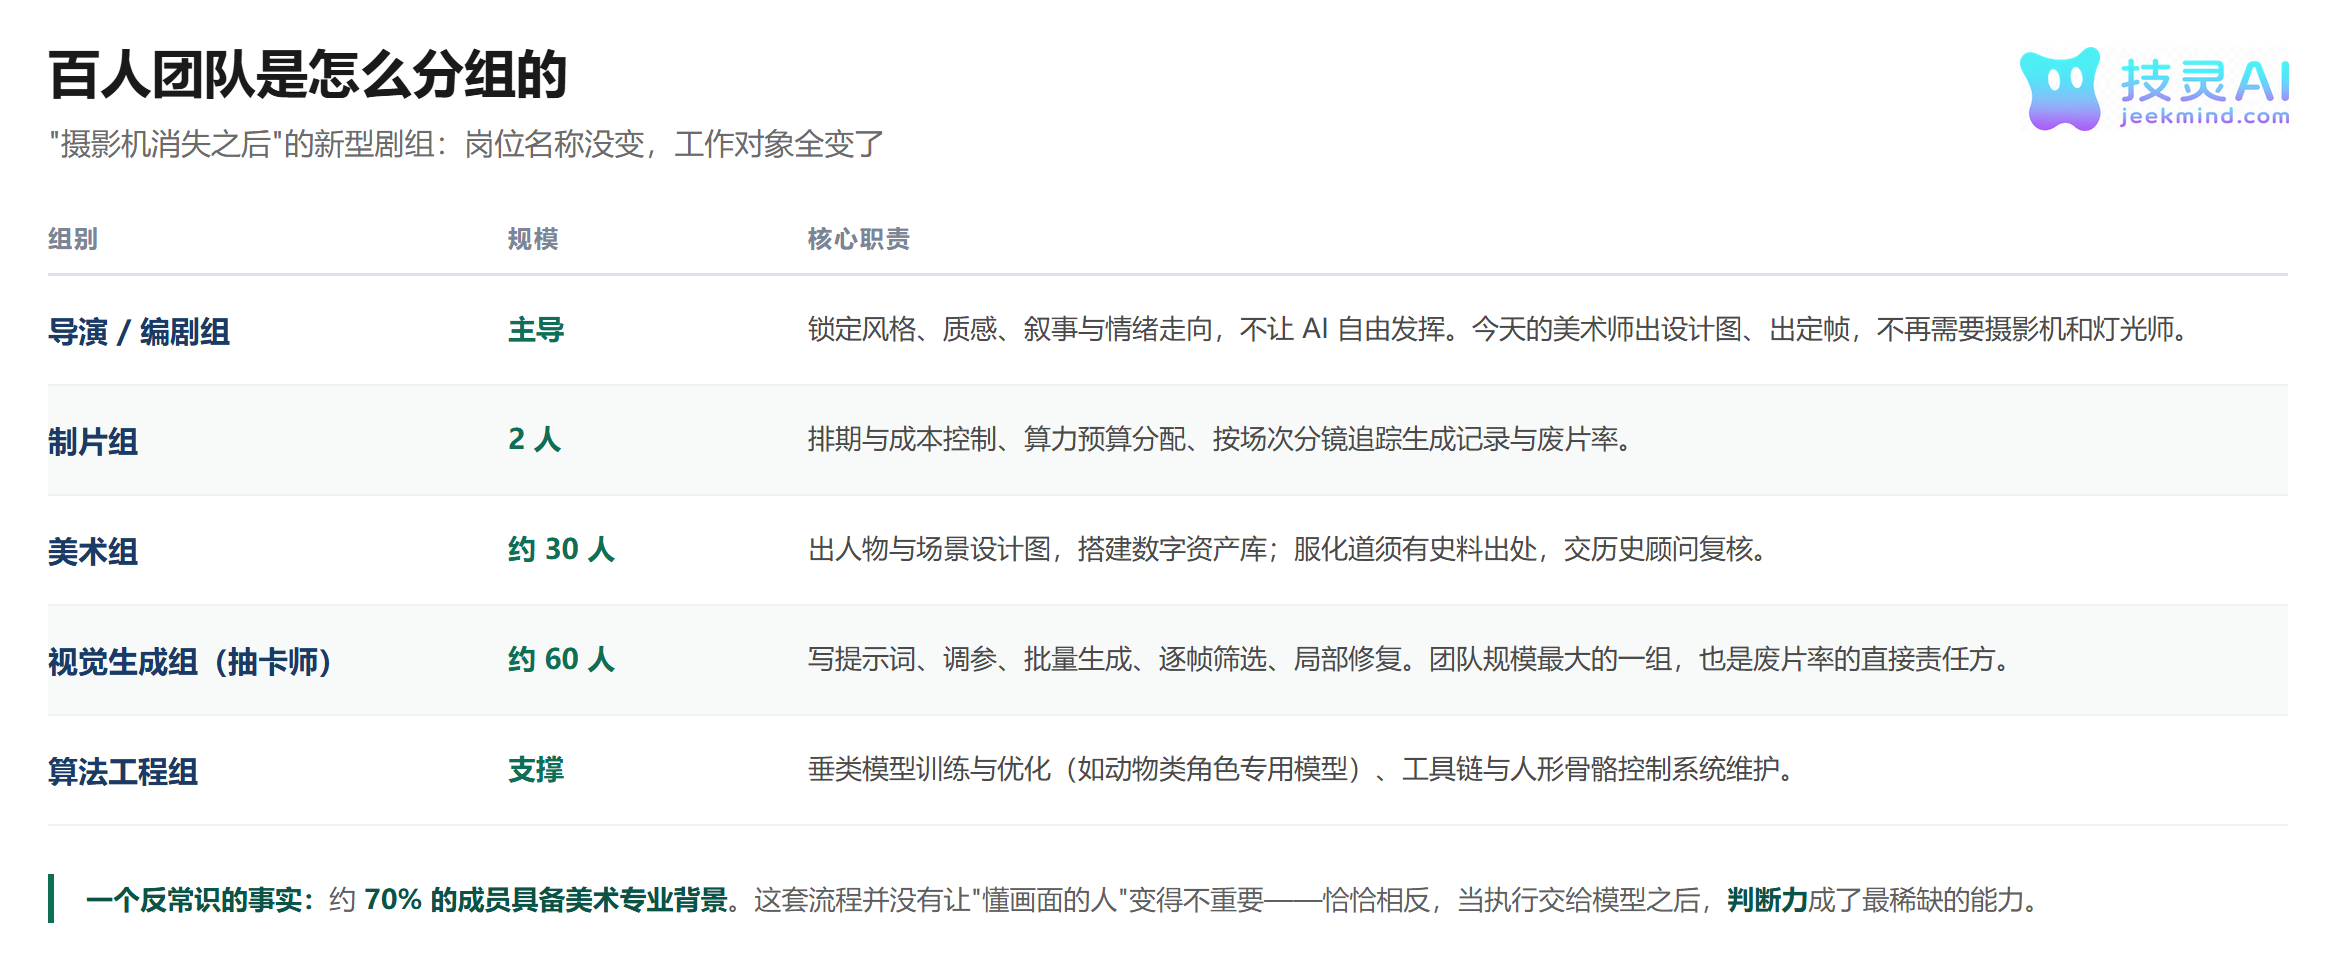
图 7:所谓"摄影机消失之后"的新型剧组
值得注意的是:约 70% 的成员具备美术专业背景。这套流程并没有让"懂画面的人"变得不重要——恰恰相反,当执行交给模型之后,判断力成了最稀缺的能力。
制片组只有 2 个人,却要负责排期、成本与算力预算——因为平台支持按项目、成员、场次、分镜追踪每一次生成记录,废片率与成本一目了然。透明度带来了杠杆。
七、五个最容易踩的坑
| 坑 | 表现 | 对策 |
|---|---|---|
| 设定图缺元素 | 表演莫名僵硬、表情受限 | 资产定稿前逐项核对"不可变细节清单" |
| 同义改写提示词块 | 角色缓慢漂移,几集之后脸变了 | 固定提示词块逐字粘贴,进版本管理 |
| 复合运镜 | 时序崩坏、画面撕裂 | 单镜只做一个主动作,运镜只选一种 |
| 版本悄悄替换 | 接戏链断裂,全段返工 | 已通过版本进白名单,禁止静默替换 |
| 长接龙不重锚 | 误差累积,越接越偏 | 每隔几段回到角色资产卡重新锚定 |
八、这套流程意味着什么
AIGC 长剧最容易被误解的地方,是把它当成"降本增效的捷径"。
但真正跑通过一遍的团队会告诉你相反的结论:它要求你把前期做得更重,而不是更轻。 剧本要拆得更细,美术要定得更死,资产要封得更完整。省下来的是执行,不是判断。
而这恰恰是它真正的价值——当执行可以被规模化复制之后,创作者的精力终于能回到内容本身。一部好的 AI 长剧,首先得是一部好的剧,一部能让观众彻底忘记技术存在的作品。
这套流程里最难被复制的,其实不是提示词,而是"资产能不能被反复调用"这件事——它要求工具本身存得住角色、存得住场景、存得住镜头之间的接戏关系。技灵AI 正在做的就是这样一件事:一站式 AI 内容生产平台,把内容策划、图片与视频生成、资产沉淀放进同一条工作流。
其中无限画布是专为系列化内容准备的:同一项目里的角色、场景与风格可以在画布上反复调用,从脚本到分镜再到成片在同一空间完成,团队多人协作、创作资产持续沉淀——也就是本文讲的"资产化"。
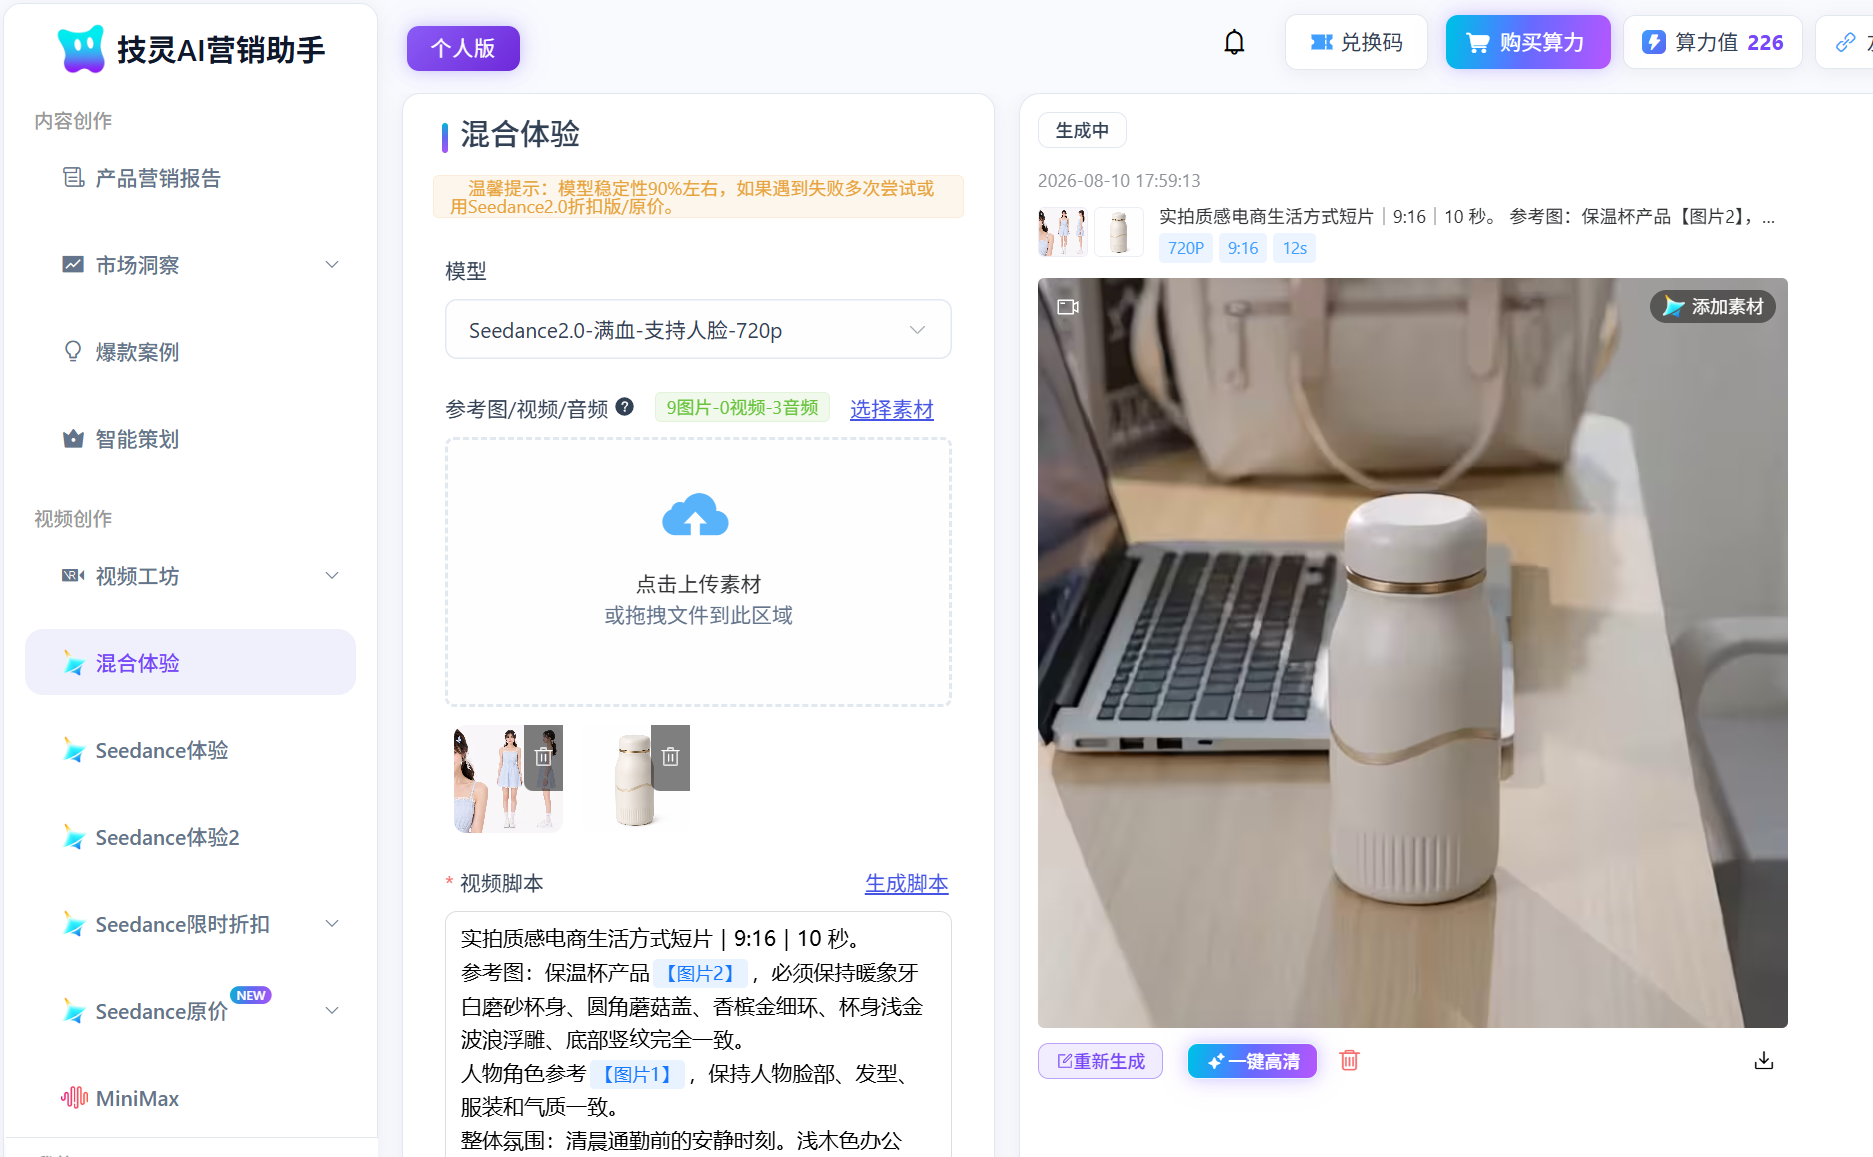
图 8:技灵AI 视频工坊「混合体验」界面——左侧选定模型档位(含 Seedance 系列)并挂载参考素材、写入视频脚本,右侧直接预览生成结果
如果你也在做长内容,或者想看看这套流程在工具里长什么样,欢迎来 https://www.jeekmind.com 聊聊你的项目。